Compactação de raciocínio faz agentes pensarem 20% a 50% menos, mas o custo varia
Um paper reescreve o raciocínio antigo de agentes em registros curtos e mede o efeito em seis modelos abertos. O raciocínio encurta, mas o gasto total varia por modelo.
A compactação de raciocínio é a ideia de um paper do arXiv, enviado em 2 de novembro: reescrever o raciocínio antigo do modelo em registros curtos, e o próprio modelo passa a gastar menos tokens de raciocínio nos passos seguintes, sem retreino. Em testes controlados com seis modelos de pesos abertos, a mediana da redução ficou entre 20,2% e 50,5%. Para quem paga por token num agente de código, é uma ideia barata de testar, mas o custo total não caiu em todos os casos.
Por que o raciocínio longo pesa na conta?
Modelos de raciocínio escrevem um rascunho antes de responder e cobram por cada token desse rascunho. O paper cita dados da Artificial Analysis, coletados em 3 de agosto de 2026: o raciocínio responde por 84,9% dos tokens gerados pelo GLM 5.2 e por 75,1% dos do Claude Fable 5. No DeepSeek V4 Pro, só os tokens de raciocínio somam 53,4% do custo da API, conforme o texto completo do paper.
Num agente, o problema se repete. Cada passo reenvia o histórico inteiro como entrada, incluindo todos os rascunhos anteriores, e o modelo paga de novo para lê-los. O autor, Anton Hristov, parte de uma pergunta simples: se o histórico mostra rascunhos longos e repetitivos, o modelo imita esse estilo? Se mostra registros curtos, ele passa a escrever curto?
Como funciona a compactação de raciocínio?
Um segundo modelo, o compressor, lê cada rascunho antigo e o converte num registro de estado: decisões, números, dúvidas e a próxima ação, sem a repetição. Mensagens do usuário, chamadas de ferramenta e resultados ficam intactos. O modelo-alvo não recebe nenhuma instrução para ser breve, só enxerga o histórico mais curto, segundo o paper.
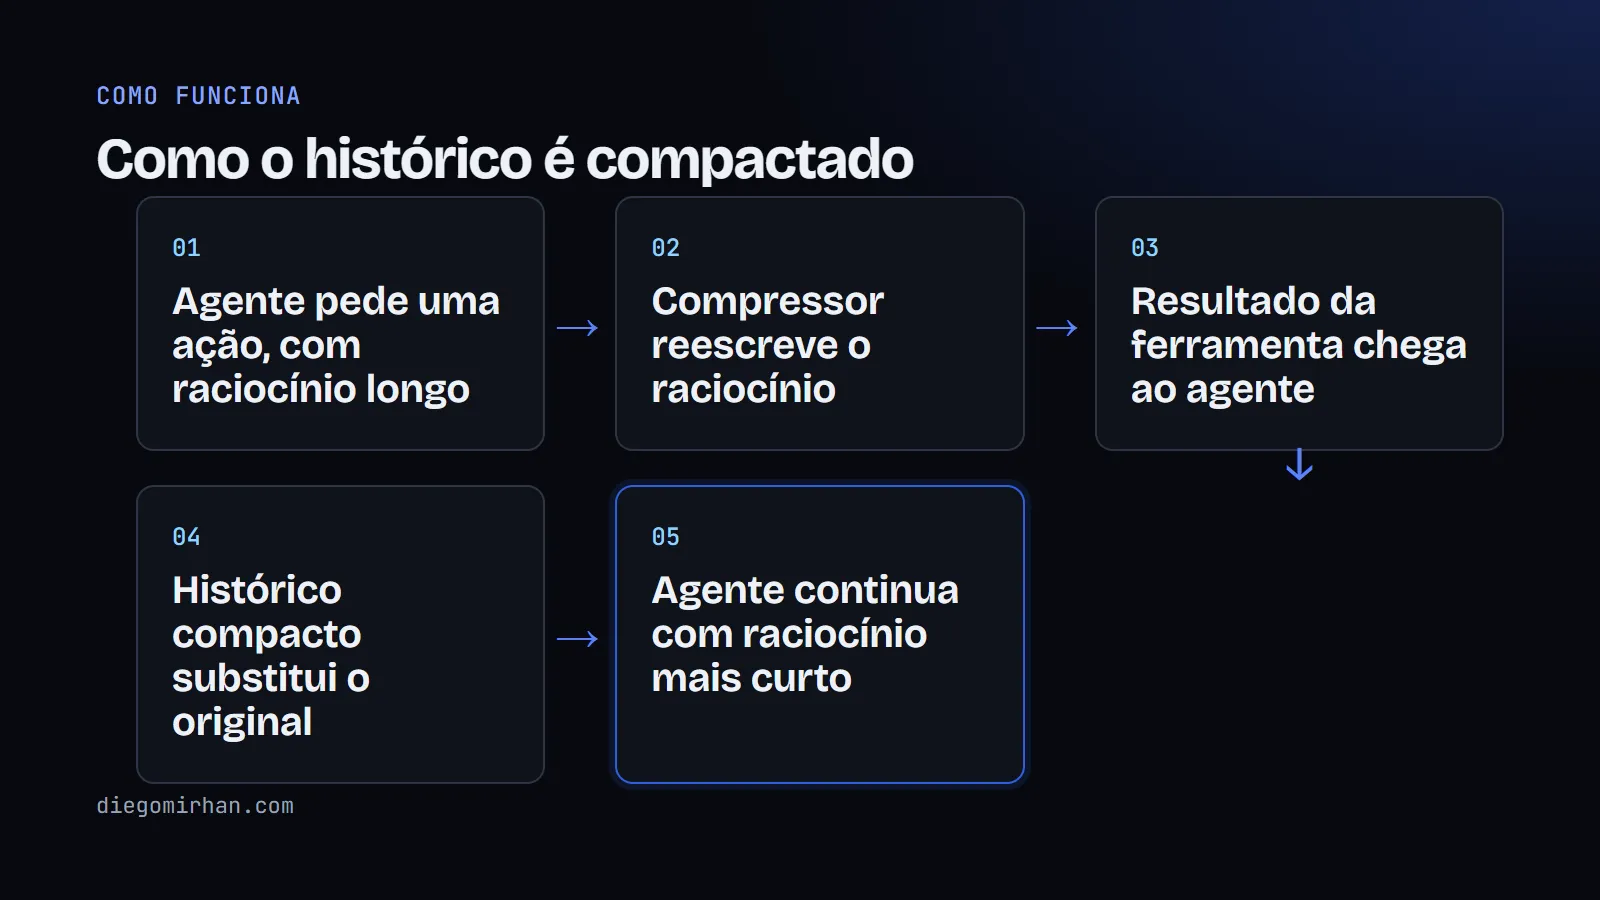
O desenho do experimento controlado tem um cuidado que vale explicar. A reescrita termina antes de a ferramenta devolver o resultado, então o compressor nunca vê o futuro. Depois, dois históricos congelados, o original e o compacto, recebem o mesmo resultado e continuam separados. A primeira resposta de cada lado difere só no raciocínio antigo, o que isola o efeito da reescrita, e os autores conferem isso campo a campo.
O que os testes controlados mostram?
Foram seis modelos, cada um com 12 tarefas de várias etapas, com respostas de ferramenta fixas e resposta final checada de forma exata. Depois dos filtros de fidelidade da reescrita, ficaram 58 dos 72 históricos, e o resultado vem de 172 pares comparáveis. A compactação encurtou o raciocínio seguinte em 151 deles (87,8%). Em 20 pares o raciocínio cresceu, com aumento máximo de 2.807 tokens, conforme a tabela 1 do paper.
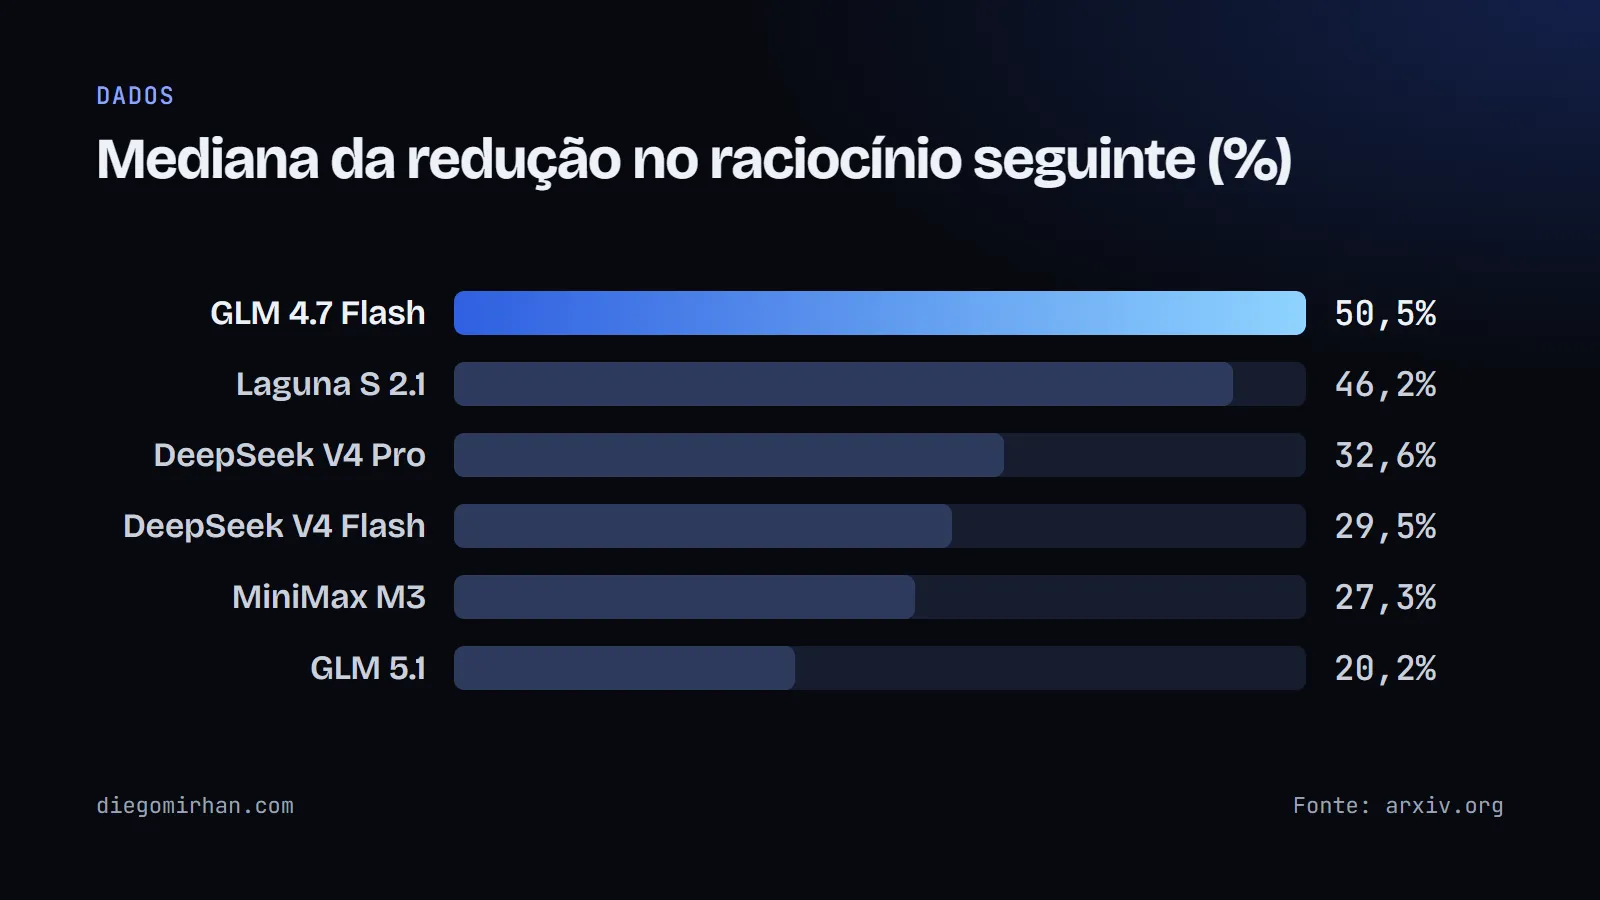
A qualidade praticamente não mudou: o total de acertos foi de 165 em 174 para 166 em 174. O GLM 4.7 Flash ganhou três acertos, mas só 5 de 12 históricos dele passaram nos filtros, e é justamente o modelo com a maior redução. Esse é o tipo de detalhe que impede de tratar a barra mais alta como o resultado típico, segundo o paper.
O controle mais importante é o das paráfrases. Reescrever o histórico com outras palavras e o mesmo tamanho, entre 90% e 110% do original, mudou a mediana do raciocínio seguinte em apenas +0,7%, e os acertos caíram de 68 em 69 para 59 em 69. Ou seja, trocar palavras não encurta nada, e a diferença parece vir do registro ser curto. Os próprios autores deixam em aberto qual parte da reescrita causa o efeito, e não testaram uma versão que só apaga trechos, que seria o concorrente gratuito, conforme o texto completo.
E num agente de código de verdade?
Para ver o efeito no bolso, os autores usaram 50 tarefas do SWE-bench Verified Mini, um subconjunto de problemas reais de repositórios do GitHub. Quatro modelos rodaram com o histórico normal e com compactação contínua, feita por um compressor externo (o GPT 5.6 Luna) ou pelo próprio modelo. A conta de gasto inclui o custo da reescrita. Seis das oito configurações saíram mais baratas, segundo a tabela 3.
O DeepSeek V4 Flash gastou 34,5% menos com compressor externo e 46,5% menos compactando o próprio raciocínio. O MiniMax M3 gastou 34,0% e 38,2% menos. O Kimi K2.6 economizou só 5,0% com compressor externo e 18,9% compactando sozinho. O Nemotron 3 Ultra foi na direção contrária: o gasto subiu 9,4% e 7,2%, conforme a tabela 3.
As palavras de histórico caem bastante, de 43,0% a 78,9% conforme a configuração, mas o gasto não acompanha por três motivos. Uma parte da economia vai embora na reescrita. Alguns agentes passam a dar mais passos: o Kimi com compressor externo fez 19,8% mais chamadas de ferramenta, e o raciocínio por resposta caiu 31,1%, mas o total caiu só 13,8%. E o tempo de reescrita pode superar o tempo ganho: só as duas configurações do MiniMax reduziram o tempo total das requisições contando a reescrita, conforme o paper.
Sobre qualidade, o placar mudou no máximo três tarefas em 50 em relação ao histórico normal. Os autores escrevem que isso não estabelece que a qualidade foi preservada.
Dá para usar, e quais são os limites?
O repositório ShortReasoning traz o código e os registros congelados dos experimentos, em Python. A página do repositório não mostra licença nem versões publicadas, e ele tem zero estrelas, então é material para reproduzir o paper, não uma biblioteca pronta para plugar no seu agente.
Os limites são extensos e o paper os lista. As tarefas controladas têm uma estrutura estreita. O mesmo modelo escreve e julga as reescritas. A auditoria humana teve só dois avaliadores sem formação técnica, com seis pares cada. O teste de agente usou uma amostra não aleatória, sem repetição de sementes, e misturou provedores diferentes. Os autores não afirmam equivalência de qualidade e dizem que falta comparar com truncar ou apagar trechos. Há ainda um aviso de privacidade: mandar o histórico para um compressor externo expõe esse conteúdo a outro provedor, então vale redigir segredos ou usar um compressor local.
Minha leitura é que o resultado útil não é a maior redução da tabela, e sim a pergunta que ele muda. Em vez de só pedir ao modelo que pense menos, dá para mexer no que ele já escreveu. Eu testaria primeiro com o modelo que já uso, num conjunto pequeno de tarefas minhas, medindo gasto total com a reescrita dentro da conta. O caso do Nemotron mostra que a mesma técnica pode custar mais, e o paper deixa claro que a decisão é por modelo, não por regra geral.
Fontes
- Why Pay for Long Reasoning When Rewrite Do Trick?, arXiv, 2 nov. 2026
- Texto completo do paper, em HTML, arXiv, 2 nov. 2026
- Repositório DebelToni/ShortReasoning, GitHub, nov. 2026
Gostou? Receba o próximo
Um e-mail a cada post novo. Sem spam.