Flide responde até 9,5 vezes mais rápido que vLLM e SGLang em modelos de decisão
Um paper de Singapura e Oxford serve modelos de decisão como uma árvore de perguntas sobre um estado. O ganho some quando há uma pergunta só, e tudo foi medido numa H200.
O Flide é um motor de inferência de pesquisadores da Universidade Nacional de Singapura e da Universidade de Oxford, publicado no arXiv em 30 de outubro, feito para modelos de decisão: os que respondem perguntas de múltipla escolha sobre um texto em vez de gerar texto. Quando várias perguntas partem do mesmo contexto, ele responde até 9,5 vezes mais rápido que o vLLM e o SGLang, segundo o paper, e o código é aberto.
Que problema o Flide resolve?
Um modelo de decisão, como o Jev da TypeSafe AI, recebe um estado (uma conversa longa, o histórico de um agente) e várias perguntas sobre ele. A saída é uma distribuição de probabilidade sobre opções fixas, não um texto, conforme o paper. Serve para rotear pedidos, avaliar respostas ou escolher o próximo passo de um agente. Como o resultado é uma probabilidade, o sistema costuma aplicar um limiar nela, e uma diferença pequena pode virar uma decisão diferente.
Segundo os autores, vLLM e SGLang foram feitos para gerar texto, em que a unidade de trabalho é uma sequência linear. Cada pergunta vira um prompt independente e o contexto compartilhado é processado de novo para cada uma. O cache de prefixo (guardar o começo já calculado de um prompt para reaproveitar) ajuda, mas em modelos híbridos, que misturam atenção com camadas recorrentes, ele só restaura o estado recorrente em fronteiras de bloco. Os tokens depois da última fronteira são recalculados a cada pergunta, segundo o texto completo.
A alternativa do SGLang, o multi-item scoring, junta todas as perguntas numa sequência só, com um token delimitador antes de cada uma. Esse delimitador entra na entrada de cada pergunta e muda as probabilidades. E há um terceiro problema: a ordem das somas em ponto flutuante muda conforme o lote, então o mesmo pedido pode render decisões diferentes dependendo da carga do servidor.
Como o Flide faz isso?
O Flide trata cada pedido como uma árvore: o estado compartilhado é o tronco e cada pergunta é um galho que enxerga só o tronco e ela mesma. Com n perguntas sobre um estado de P tokens, o caminho ingênuo calcula os P tokens do estado n vezes, mais os tokens das perguntas. O Flide calcula P uma vez, mais os tokens das perguntas, e faz tudo em uma só passada pela GPU, segundo o paper.
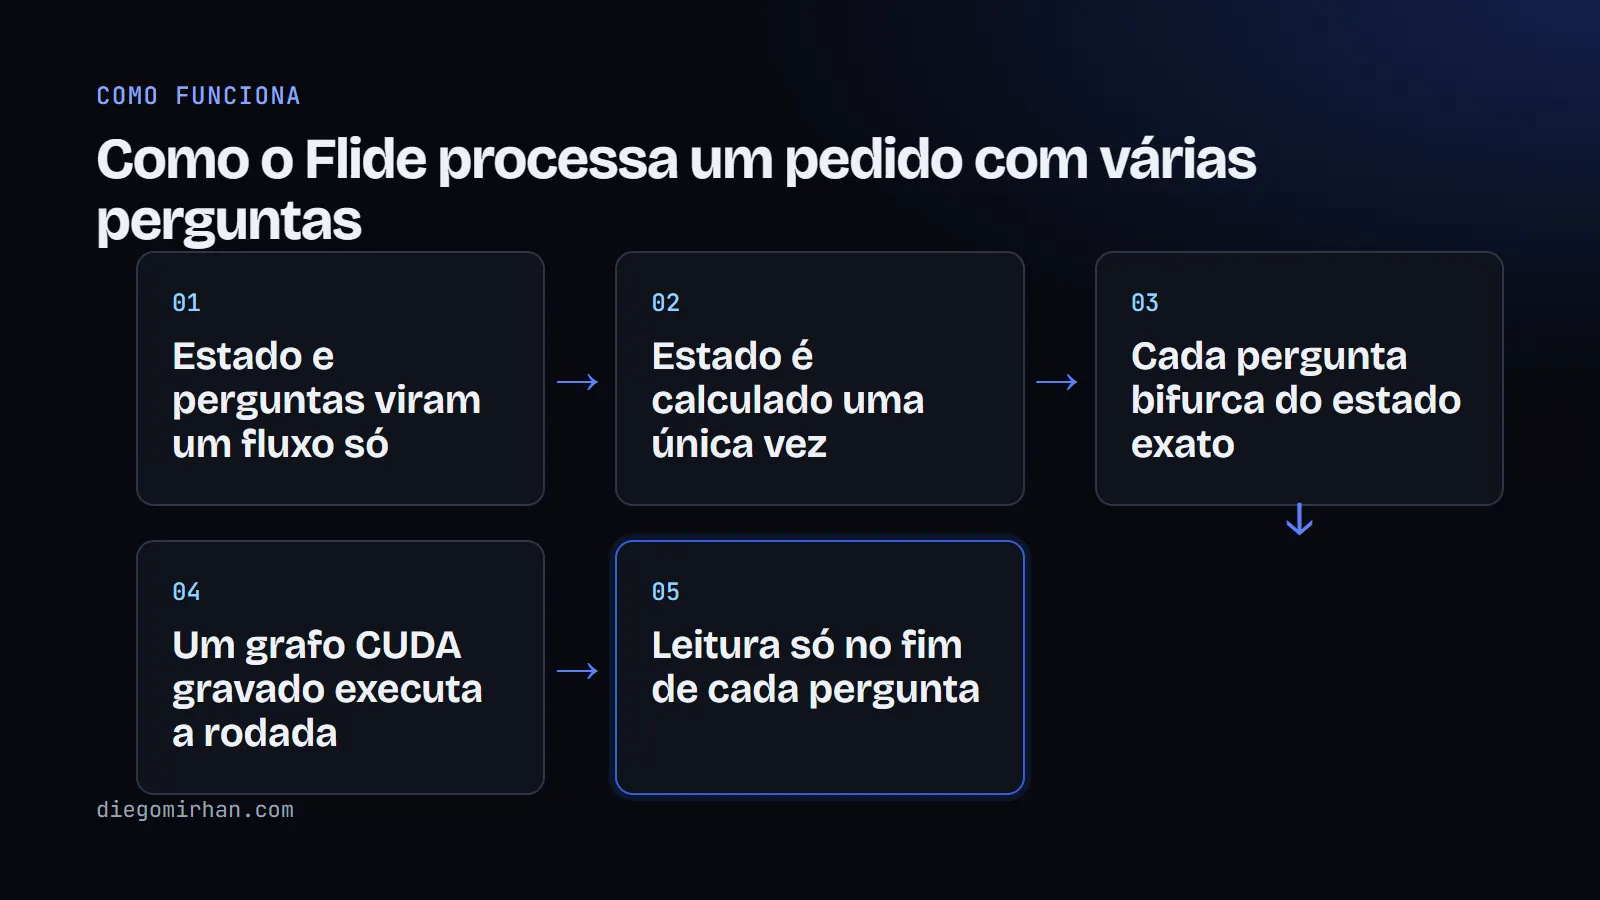
Nas camadas de atenção, uma regra de visibilidade resolve: cada token de pergunta só olha para o estado e para a própria pergunta. O difícil são as camadas Gated DeltaNet, que comprimem todos os tokens anteriores num único estado recorrente e existem em modelos como o Qwen3.5. Nelas não há matriz de atenção para mascarar. O Flide roda cada camada em duas chamadas: a primeira processa os estados e entrega o estado recorrente no fim de cada um, e a segunda processa todas as perguntas de uma vez, cada uma partindo do estado do seu próprio tronco por um índice, sem copiar nada.
Dois detalhes de engenharia completam o desenho. A árvore da rodada fica em metadados dentro da GPU, e assim um pequeno conjunto de grafos CUDA (sequências de chamadas à GPU gravadas uma vez e repetidas sem custo de disparo) atende qualquer mistura de pedidos. E, para agentes, o estado de uma rodada vira um checkpoint que o passo seguinte retoma, em vez de recalcular o histórico. Há ainda um modo opcional que fixa a ordem das somas para que a resposta seja idêntica bit a bit com qualquer carga.
O que os números mostram?
Os autores mediram em uma GPU NVIDIA H200 com modelos Qwen3.5 e Gemma 4, em seis conjuntos de pedidos montados a partir de RACE, QuALITY, MultiRC e do Decision Index. Quando um estado carrega várias perguntas, o Flide chega a 9,5 vezes menos latência e 8,5 vezes mais vazão que o melhor concorrente. Com 64 perguntas sobre um estado de cerca de duas mil tokens, fica 12,7 vezes mais rápido que o vLLM, conforme o paper.
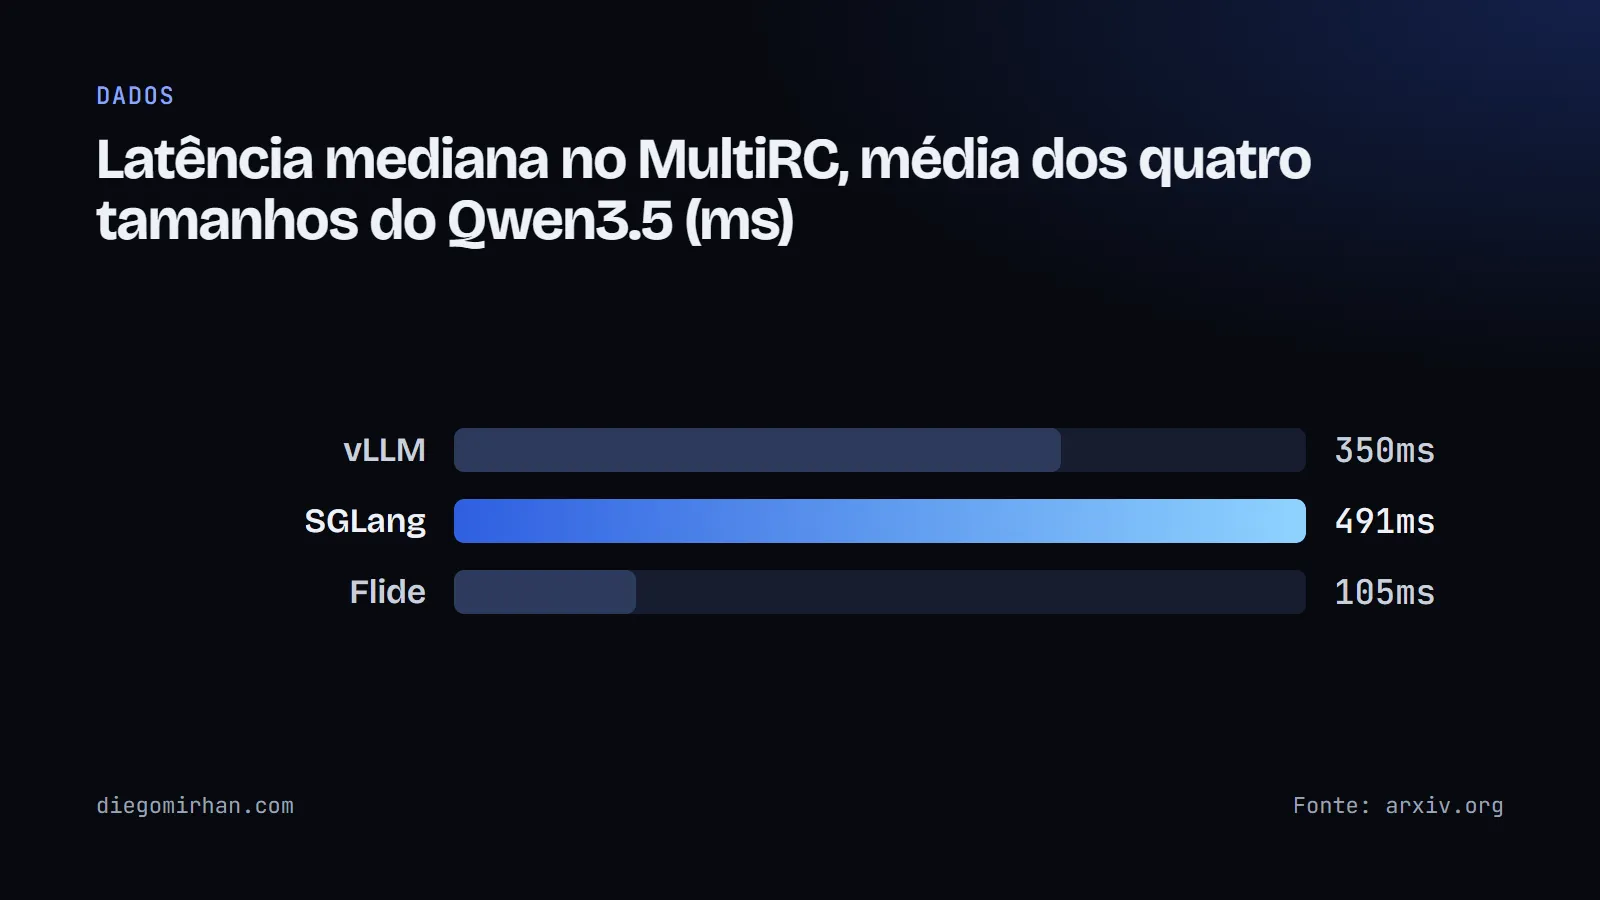
O ganho some quando não há o que compartilhar. Com uma pergunta por estado e um modelo grande sob carga, os três motores empatam: no Qwen3.5-27B com artigos do QuALITY, todos ficam em 3,3 pedidos por segundo com 64 clientes, segundo a tabela 3. Com uma pergunta só e o menor modelo, o Flide ainda corta a latência de um pedido isolado em até 3,2 vezes. Nos modelos de decisão dedicados, como o Open-Jev, o ganho fica em cerca de três vezes em entradas curtas e até 1,7 vez em prompts longos.
Para agentes, o paper reproduziu trajetórias de agentes de código de um conjunto público e fez várias perguntas sobre o histórico a cada passo. O custo marginal ficou perto de 1 ms por mil tokens de histórico, e o Flide completou de 4,4 a 7,2 vezes mais passos por segundo que o melhor concorrente, segundo o texto do paper.
A precisão é a outra metade da história. A acurácia do Flide fica a no máximo 1,2 ponto da do vLLM em todas as células da tabela. Entre 1 e 64 clientes simultâneos, as respostas mudam em no máximo 0,2% dos casos no Flide, contra até 1,7% no SGLang e até 3,2% no vLLM. O delimitador do multi-item scoring inverte até 29% das decisões categóricas, e o Flide, no máximo 2,3%, segundo a mesma análise.
Dá para usar hoje?
O repositório tem licença Apache-2.0. Segundo o README, a instalação é um pacote Python e o servidor sobe com o comando flide serve e o nome de um modelo, expondo a API de decisão do Jev. Há opções para guardar os estados de requisições anteriores, para o modo de resposta idêntica bit a bit, que custa alguma velocidade, e para rodar o Qwen3.5 em FP8. Uma demonstração de triagem de e-mails marca 10.000 mensagens com oito perguntas cada em 28 segundos numa H200, e a versão 0.1.12 trouxe kernels pré-compilados para as placas RTX 50 e RTX PRO 6000.
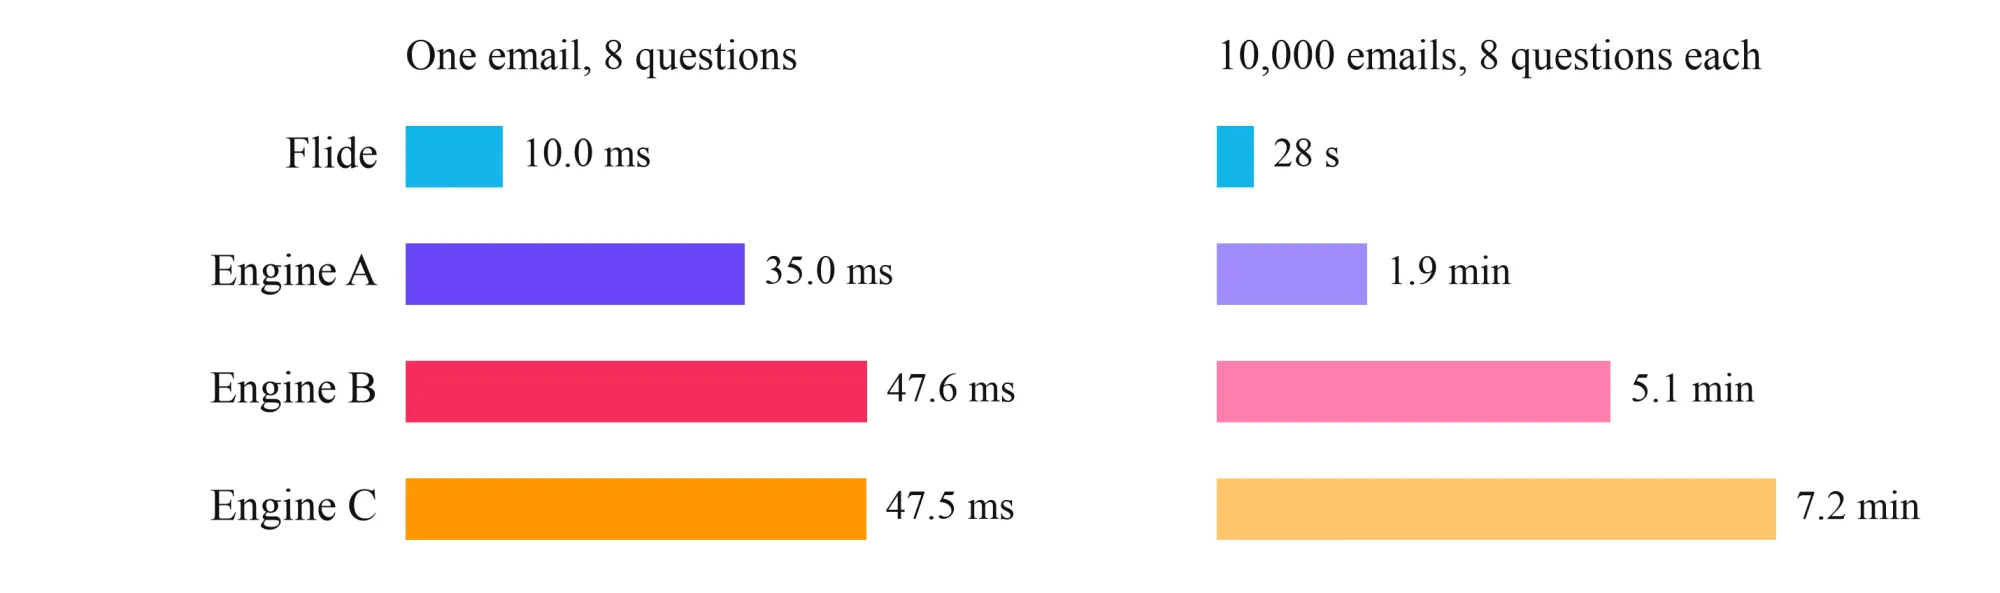
O ganho varia muito conforme o modelo e a carga. A tabela do README vai de cerca de 1,0 vez, em modelos como Gemma 4 nos artigos do QuALITY, até 28,1 vezes, no Senova em MultiRC. Ou seja, o número de 9,5 vezes é o teto do paper, não o que se deve esperar de qualquer pedido.
Quais são os limites?
Tudo foi medido numa H200, e o README que li cita só placas NVIDIA, sem menção a AMD ou ROCm. Os concorrentes foram configurados e medidos pelos próprios autores, e o SGLang renderiza os prompts com o seu próprio modelo de formatação, o que mexe na comparação. A garantia de resposta exata vale em aritmética exata: em ponto flutuante, as diferenças ficam no nível de arredondamento, e a igualdade bit a bit só existe no modo opcional. E o motor serve para decisão, com respostas de uma etiqueta ou de uma posição treinada, não para geração de texto.
Minha leitura é que a ideia vale mais que o motor: tarefa de classificar, rotear ou checar política deve ser servida como árvore de perguntas sobre um estado, e não como uma fila de prompts que repetem o mesmo contexto. Quem monta um agente com várias perguntas sobre o mesmo histórico tem o que ganhar, e quem faz uma pergunta por estado quase nada. Antes de trocar o motor, eu contaria quantas perguntas o meu fluxo faz por estado e rodaria o meu próprio conjunto, porque os números do paper são de uma GPU H200.
Fontes
- Flide: Accelerating Decision Inference with Exact State Forking, arXiv, 30 out. 2026
- Flide, versão em HTML, arXiv, 30 out. 2026
- Repositório OmniJev/flide, GitHub, nov. 2026
Gostou? Receba o próximo
Um e-mail a cada post novo. Sem spam.