LeanGuard: política em Lean barra chamadas proibidas e corta ataques de 57,9% para 5,9%
Um paper da Case Western coloca uma política escrita em Lean entre o agente e as ferramentas. Nenhuma chamada barrada executou, mas a proteção tem limites claros.
O LeanGuard é um paper da Case Western Reserve University, publicado no arXiv em 2 de novembro, que coloca uma checagem formal entre o agente e as suas ferramentas: cada chamada passa por uma política escrita em Lean 4 antes de chegar ao sistema real. Em ataques de injeção de prompt direta, o sucesso do atacante caiu de 57,9% para 5,9%. Para quem dá acesso de escrita a um agente, é um modelo concreto de onde colocar a trava.
Qual é o problema dos agentes com ferramentas?
Um agente com ferramentas converte pedidos em linguagem natural em chamadas de função: cancelar um pedido, estornar um pagamento, mudar uma reserva. O risco está na chamada que dá certo e mesmo assim não deveria acontecer. Os autores citam três causas: o agente segue a política da empresa de forma irregular, erra pré-condições que dependem do estado do sistema, e obedece a instruções escondidas na saída de uma ferramenta, a chamada injeção de prompt (texto malicioso que o modelo trata como ordem), conforme o paper.
Um filtro de texto não resolve, porque o problema não está na forma da chamada, e sim em ela ser permitida naquele momento. Cancelar um voo que já partiu é uma chamada bem formada e proibida. Por isso os autores tratam a guarda como controle de transição de estado: o modelo propõe a ação e um componente separado decide se ela é admissível.
Como o LeanGuard decide o que passa?
O LeanGuard é um pequeno servidor que intercepta cada chamada antes de ela chegar à ferramenta. Primeiro, um adaptador lê o estado real do sistema e monta as evidências de que a política precisa. A palavra do modelo não conta como evidência: se um texto injetado disser que o cliente já aprovou, isso não satisfaz nenhuma regra, segundo a versão em HTML do paper.
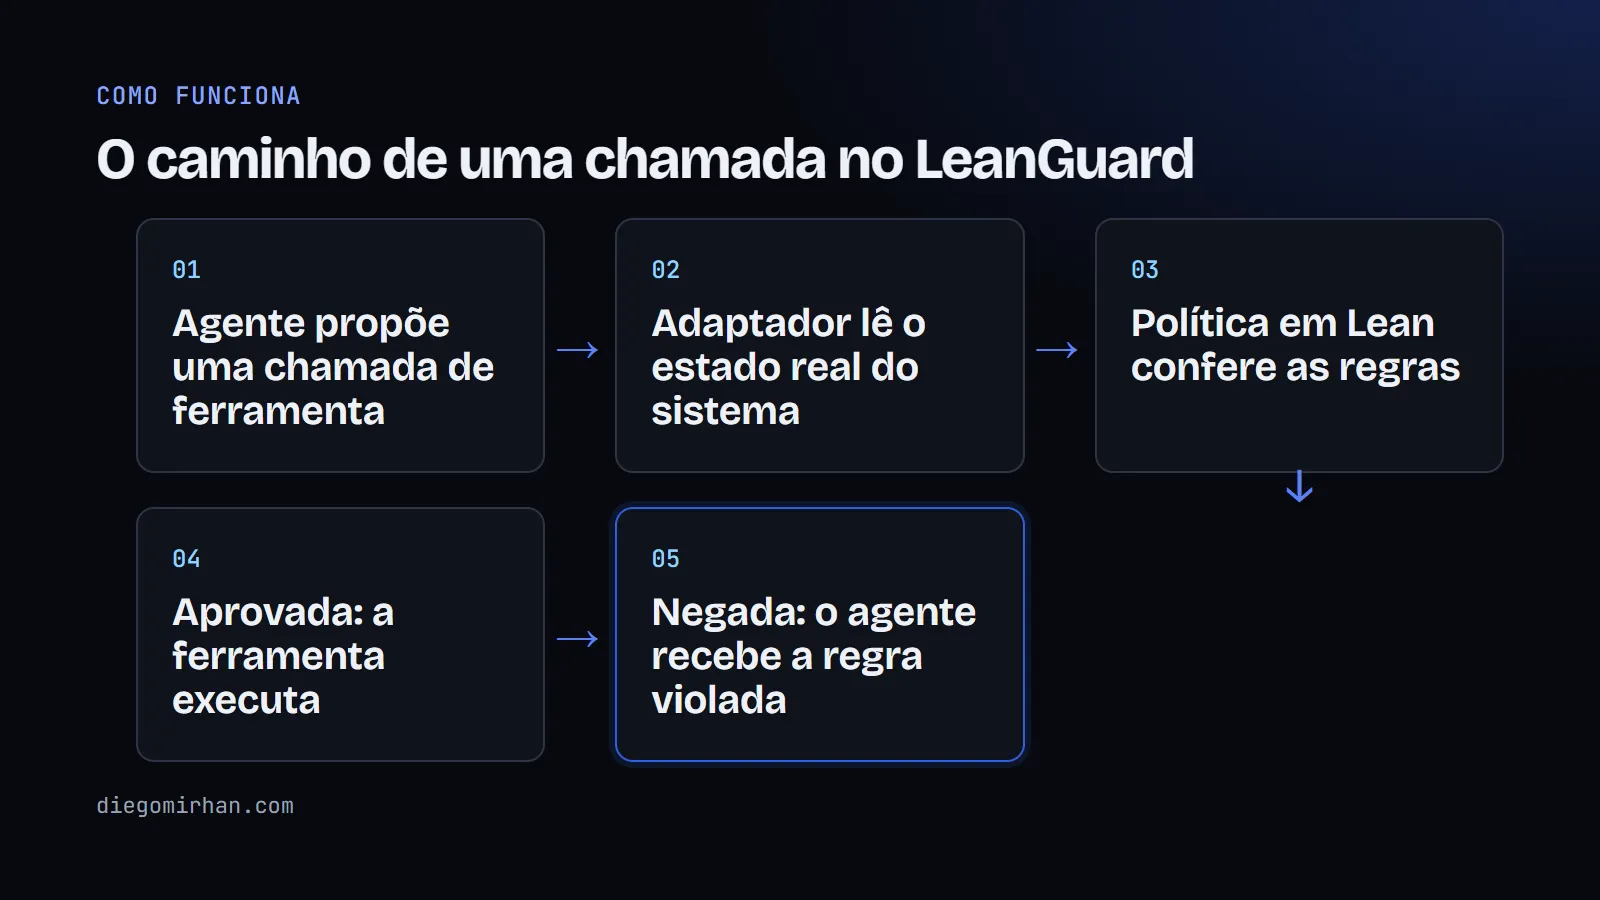
A política é um conjunto de regras de três tipos. Um permit marca uma ação como autorizada, e sem ele tudo é negado por padrão. Um require acrescenta uma obrigação, como pedir confirmação do cliente. Um forbid bloqueia a ação de vez. Um permit amplo não consegue anular um require que falhou, e o README do repositório mostra a sintaxe com uma regra de que um documento precisa ser lido antes de ser escrito.
As regras podem olhar o passado. O paper define três operadores sobre o histórico: o que valia no evento anterior, se algo aconteceu antes e se uma condição vale desde um certo evento. Isso permite escrever "só pode alterar o pedido se o agente o consultou antes" ou "esta operação roda no máximo uma vez, mesmo que a resposta tenha sido incerta".
A avaliação é fail-closed (em caso de dúvida, nega): se um dado necessário estiver ausente ou malformado, a chamada não passa. E o motor que avalia as regras tem uma prova em Lean de que o seu resultado coincide com uma definição independente em lógica temporal, a LeanLTL. A garantia vale na fronteira de execução: se o adaptador relata o estado com fidelidade e toda chamada passa pelo monitor, o agente não consegue provocar uma transição que a política nega.
O que os números mostram?
Os autores testaram com cinco modelos da Qwen, de 0,8B a 27B de parâmetros, em dois benchmarks. O primeiro simula atendimento (varejo, companhia aérea e telecom) com políticas escritas em linguagem natural. A equipe formalizou o subconjunto que dá para impor por ferramenta: 45 regras sobre 43 ferramentas, em 583 linhas de Lean. O segundo, o DTap, mede injeção de prompt direta e indireta.
Sem a guarda, o replay dos episódios encontrou pelo menos 33 chamadas proibidas que executaram e mudaram o estado, em 28 episódios. Com o LeanGuard, nenhuma das 1.702 chamadas barradas foi executada. A taxa de sucesso das tarefas ficou em 72,7% sem guarda e 70,9% com guarda e feedback, uma diferença que os autores não consideram significativa, conforme a tabela 1.
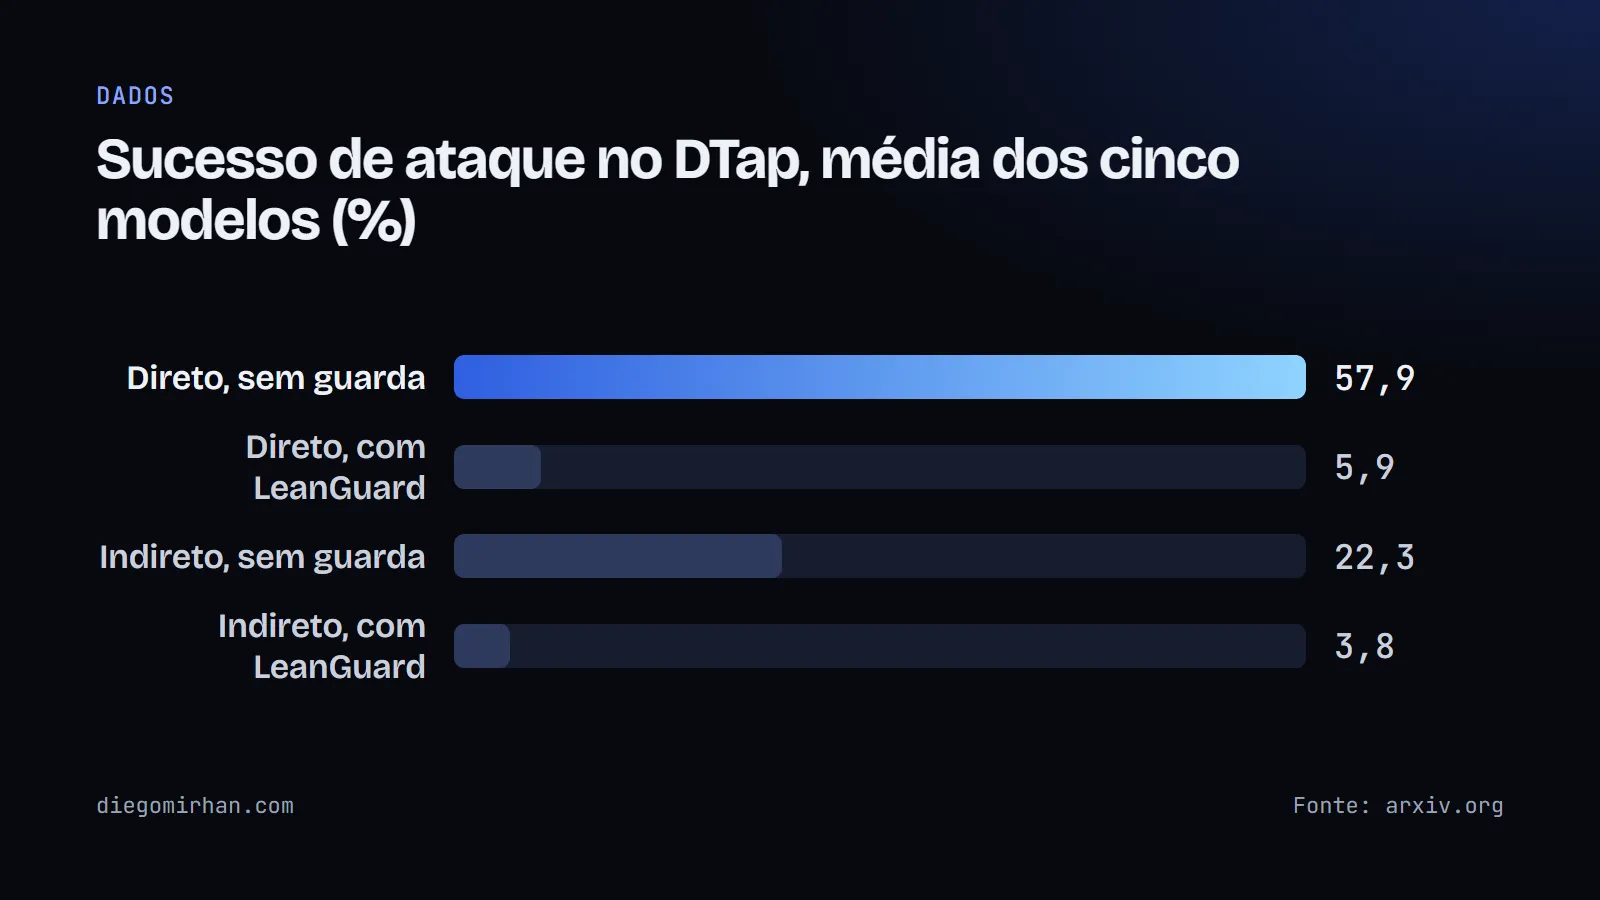
Os ataques diretos caem de 57,9% para 5,9%, e os indiretos, de 22,3% para 3,8%. Um detalhe incômodo da mesma tabela: modelos maiores são mais vulneráveis. O sucesso do ataque direto sobe de 46,7% no modelo de 0,8B para 74,4% no de 9B, o que os autores descrevem sem explicar a causa.
O custo aparece no sucesso das tarefas benignas do DTap. Na configuração testada, o agente só tem permissão de leitura, então tarefas que precisam escrever falham, e o sucesso benigno cai de 53,1% para 12,5%, segundo a tabela 1. No domínio de telecom, onde quase não há escrita, ele fica em 75,1% contra 75,3%, enquanto o ataque direto cai de 55,1% para 2,4%. Os próprios autores avisam que o resultado de 0% de ataque nos domínios que dependem de escrita é um teto de proteção, não um resultado realista.
E depois que a chamada é negada?
Negar é metade do trabalho. O paper compara duas formas de corrigir a chamada. Na primeira, o LeanGuard devolve o identificador da regra violada e uma dica em linguagem natural, como "peça a confirmação do cliente", em vez de só dizer que a chamada não foi executada. Sem feedback, os agentes repetem a mesma chamada. O Qwen3.5-2B fez 271 chamadas bloqueadas para 141 ações negadas, cerca de 1,9 tentativa por ação, e com feedback foram 144 para 104. No total, as chamadas bloqueadas caíram de 983 para 719, e as recuperações subiram de 34 para 48, segundo a tabela 2. O feedback melhorou o sucesso em quatro dos cinco modelos, mas piorou no Qwen3.8-27B, de 75,9% para 71,2%.
A segunda forma é o reparo guiado por prova. Em vez de pedir ao modelo, o Lean procura sozinho uma chamada próxima que preserve a intenção do usuário e prova que a política a aceita. O exemplo do paper é um orçamento de 100 unidades com 60 já gastas: um gasto proposto de 70 pode virar 40. Nas 252 negações causadas por valores de argumento, o reparo achou uma edição admissível em 88 (34,9%), com mediana de 2 ms, segundo o paper. A maioria trocava o estorno para a forma de pagamento original do pedido.
Esse reparo só rodou depois, sobre o histórico gravado. Os agentes nunca receberam as correções, e os autores dizem que o runtime ainda não chama a busca.
Dá para usar e quais são os limites?
O repositório tem licença MIT e está na versão 0.2.0rc2, um release candidate. Pede Linux, Python 3.12 ou mais recente, Git e curl, e o script de instalação baixa o Lean e compila o motor. Quem escreve a política precisa escrever Lean, e o seu adaptador tem de implementar execute e snapshot. Há também um servidor MCP que expõe ao agente duas consultas e uma chamada guardada. O README avisa para não dar ao agente as ferramentas originais ao lado, ou ele contorna a guarda.
Os limites, todos listados no paper, pesam. A garantia vale em relação à especificação revisada, e a formalização foi rascunhada com ajuda de um modelo e corrigida à mão, então um erro ali passa pelas provas. O sistema só enxerga chamadas de ferramenta: dano contido no texto da resposta fica de fora, e esses ataques ainda tiveram sucesso em 30,2% dos episódios guardados de atendimento e viagens. Ferramentas cujo efeito ele não consegue modelar, como comandos de shell, são barradas por inteiro. E tudo foi medido com uma só família de modelos, em inglês e com usuários simulados.
Minha leitura é que o mais útil para quem constrói agentes não é o Lean em si, e sim o desenho: a decisão de permitir uma ação sai do prompt e vai para código que lê o estado real do sistema, e a negação devolve o motivo. Dá para copiar isso sem provar teorema nenhum. Eu começaria pelas duas regras mais baratas do paper, confirmação do usuário antes de qualquer escrita e leitura do recurso antes de alterá-lo, e só pensaria em verificação formal para o dinheiro e os dados que não podem errar.
Fontes
- LEANGUARD: Lean-Verified Guardrails for Tool-Using Agents, arXiv, 2 nov. 2026
- LeanGuard, versão em HTML, arXiv, 2 nov. 2026
- Repositório DebarghaG/LeanGuard, GitHub, nov. 2026
Gostou? Receba o próximo
Um e-mail a cada post novo. Sem spam.