OpenGCUA: agente de computador que escreve código sobe 19,6 pontos no OSWorld-v2
O OpenGCUA deixa o modelo escrever um programa por passo em vez de clicar. Em oito modelos, a nota sobe 19,6 pontos e os passos caem 53%. O código é Apache-2.0.
O OpenGCUA, publicado no arXiv em 15 de outubro pelo time Tongyi-MAI, da Alibaba, mostra que um agente de computador rende mais quando escreve código em vez de só clicar na tela. Nas 82 tarefas offline do OSWorld-v2, a nota média de oito modelos subiu 19,6 pontos e o número de passos por tarefa caiu 53%. O repositório tem licença Apache-2.0, mas é prévia, e só roda em macOS.
O que é um agente de computador e qual é o problema?
Um agente de computador é um modelo que usa o computador como uma pessoa usaria: olha a tela, clica, digita e abre programas. O padrão até aqui é o ciclo de captura de tela, decisão e clique, repetido dezenas de vezes por tarefa. Cada volta custa uma chamada ao modelo, e uma tela só mostra o que está visível naquele momento.
O paper parte de uma observação simples: o desenho do agente (a "harness", o programa que cerca o modelo) decide quase tudo por regra fixa. Quando observar, como agir e como organizar o trabalho já vêm decididos, o modelo só preenche lacunas. Os autores chamam de GCUA, agente generalista de uso de computador, o desenho em que o modelo escolhe essas três coisas a cada passo.
Como o OpenGCUA funciona?
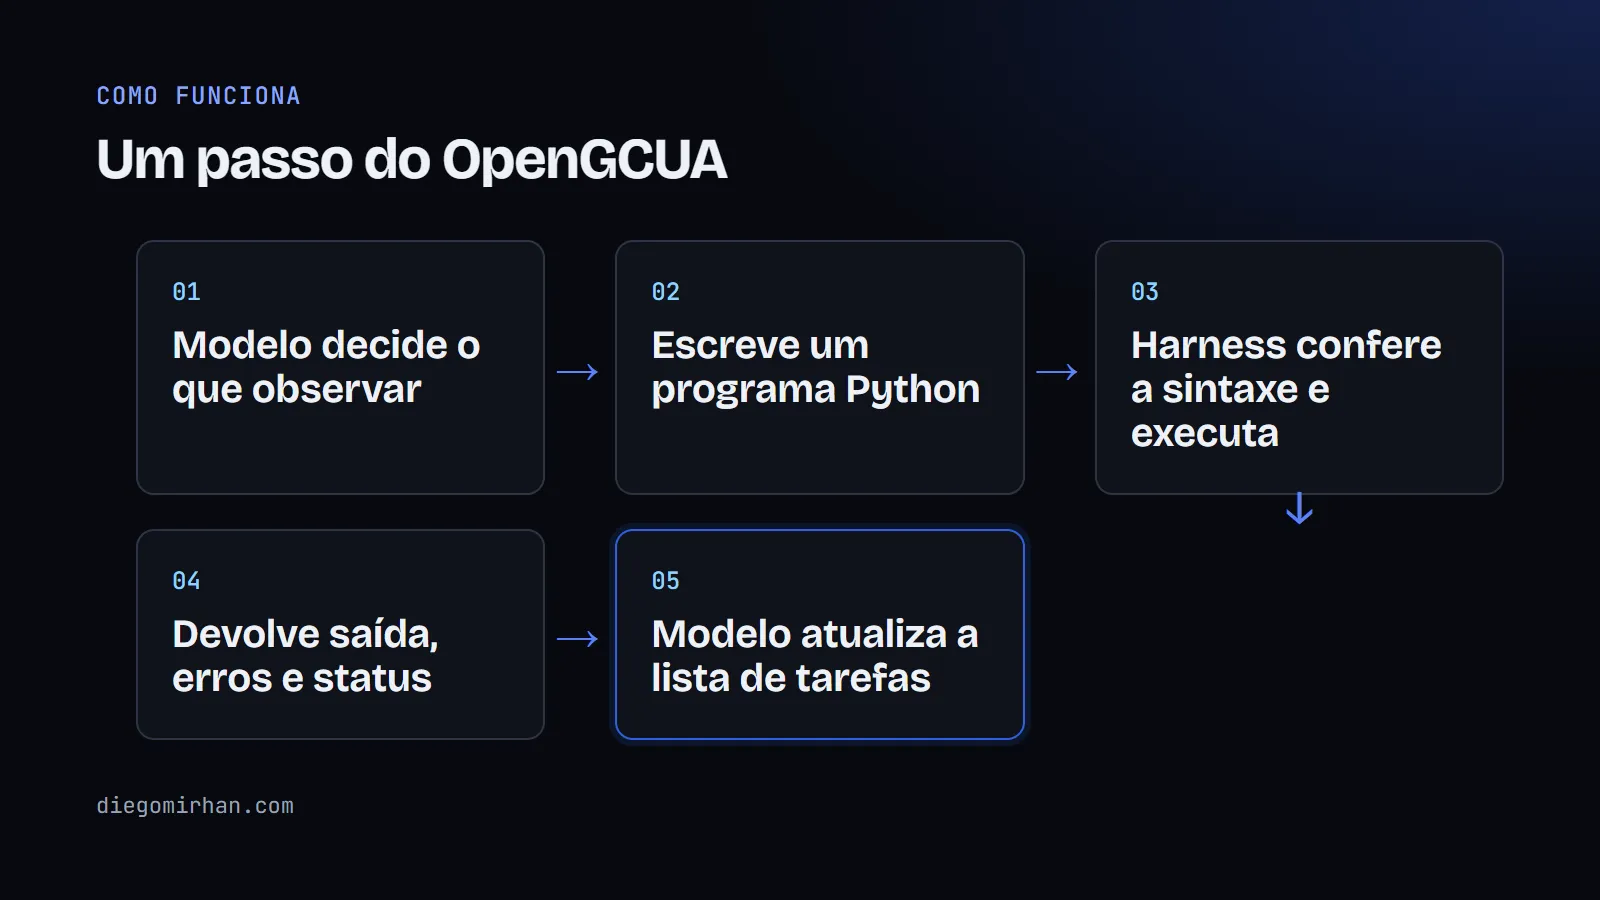
A ideia central é a execução de código. Em vez de um clique por vez, o modelo escreve um programa Python por passo. Segundo o paper, o programa pode combinar ações de interface (com PyAutoGUI), comandos de shell e, no teste em dispositivo real, o navegador automatizado Playwright. Laços, condições e conferências do resultado intermediário rodam dentro do mesmo passo, sem outra chamada ao modelo.
Há ainda quatro decisões que saem da regra fixa e passam ao modelo. A primeira é pedir captura de tela só quando precisar; o ambiente grava uma por passo, mas o modelo não é obrigado a olhar. A segunda é manter uma lista de tarefas, com status como "não verificado". A terceira é declarar a intenção de cada programa antes de rodá-lo. A quarta, que continua com a harness, é a política de contexto: um buffer de capturas recentes e a compactação de saídas antigas.
Quanto o agente melhora nos testes?
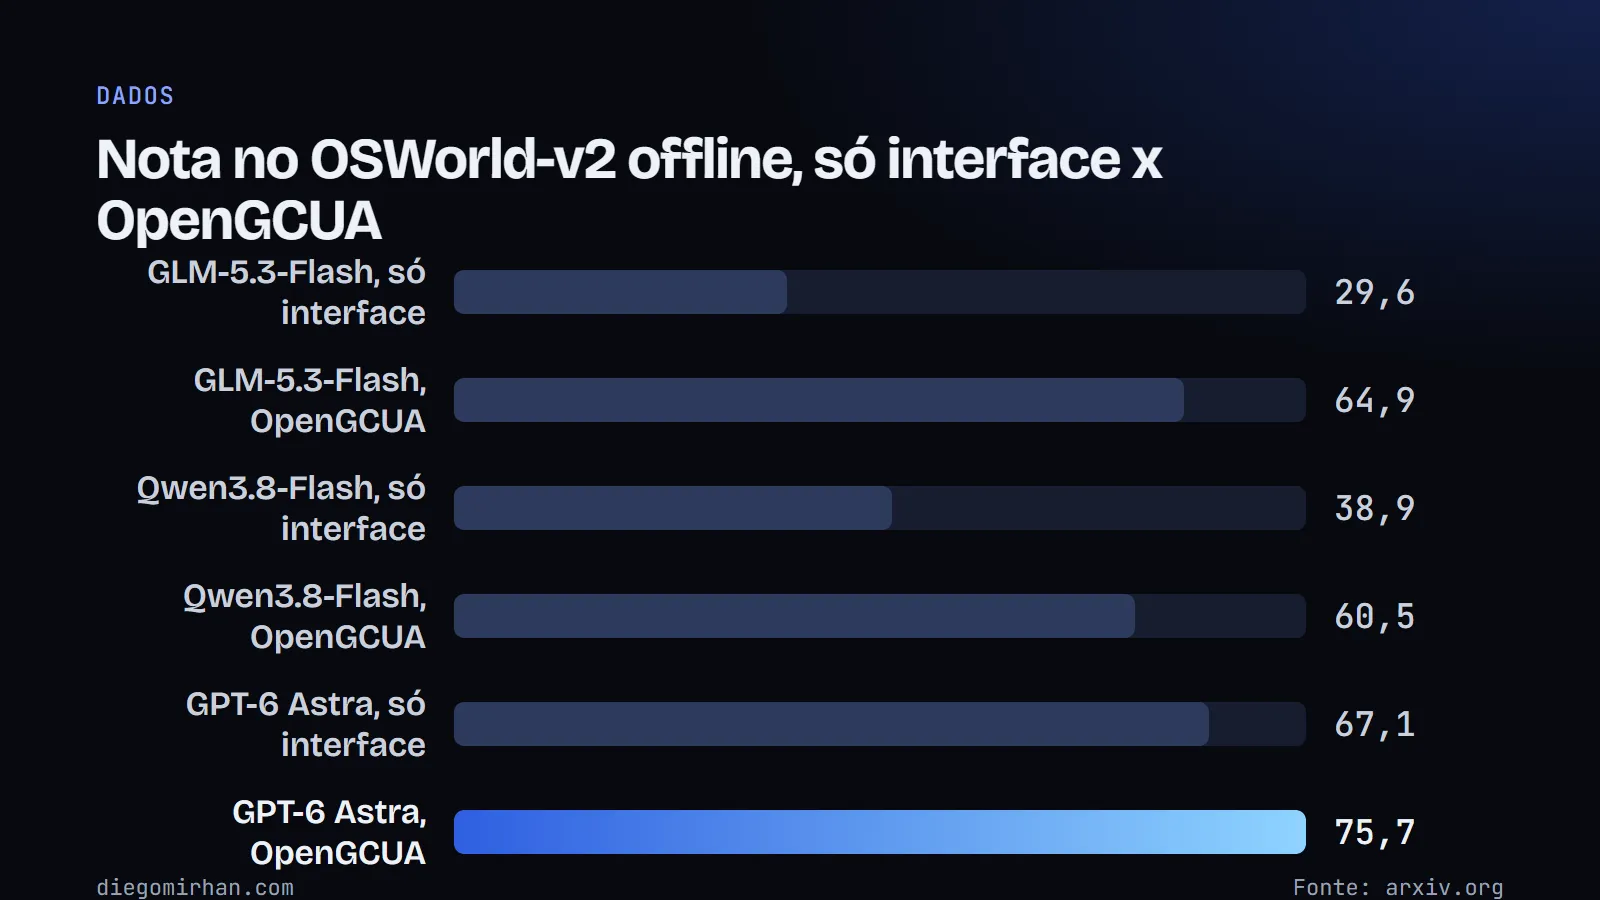
O benchmark é o OSWorld-v2, e os autores usaram as 82 tarefas que não precisam de internet. O ponto de comparação é o mesmo modelo como agente de interface gráfica, com ações em lote. Segundo a tabela do paper, o GPT-6 Astra foi de 67,1 para 75,7, o Claude Opus 5 de 60,7 para 70,1 e o Qwen3.8-Flash de 38,9 para 60,5. O maior salto foi o do GLM-5.3-Flash, de 29,6 para 64,9, e o do DeepSeek-V4.1-Flash, de 28,0 para 57,7.
A economia de passos acompanha. O GPT-6 Astra passou de 102,1 passos por tarefa para 33,5, queda de 67,2%, e o Qwen3.8-Flash de 232,0 para 86,2, segundo o paper. A média das oito combinações foi de 53,0% menos passos e 27,2% menos tokens de saída. O ganho é maior nos modelos mais fracos, o que faz sentido: um programa que repete uma ação dez vezes poupa o modelo de acertar dez cliques seguidos.
O que cada peça contribui?
O código pesa mais do que o resto. Em relação ao agente só de interface, o paper relata ganhos de 15,5 a 33,6 pontos só com a execução de código. Contra um agente que já combina interface e linha de comando, a vantagem cai: o repositório fala em 6,1 pontos a mais e 14,8% menos passos, na média de três modelos.
As quatro decisões transferidas ao modelo ajudam menos e de forma irregular. A captura de tela sob demanda e o buffer de capturas subiram a nota do Qwen3.8-Max, de 62,4 para 64,3 e 64,4. Já a declaração de intenção baixou a nota dos dois modelos testados na ablação (estudo que liga e desliga cada peça): de 62,4 para 61,5 no Qwen e de 56,7 para 53,3 no DeepSeek. Os autores admitem isso, e é o tipo de detalhe que dá crédito ao resultado.
Quanto custa e o que dá para rodar?
O custo é o ponto que mais interessa a quem paga a conta. Pela estimativa do paper, o Qwen3.8-Flash chega a 60,5 pontos por cerca de US$ 0,38 por tarefa, enquanto o GPT-6 Astra chega a 75,7 por cerca de US$ 15,26. Quinze pontos a mais custam quarenta vezes mais. Para tarefas repetitivas em que 60% de acerto parcial serve, a conta favorece o modelo barato.
Do lado do código, o repositório traz agentes de referência para o OSWorld, uma harness para macOS (preliminar), um SDK entre dispositivos (também preliminar), as trajetórias dos oito modelos e um aplicativo nativo de prévia. A instalação pede macOS 14 ou mais novo, Python 3.11 a 3.14, o gerenciador uv e Rust 1.89 ou mais novo, se você compilar o SDK em vez de usar os pacotes prontos. Você também precisa de uma chave de API de um modelo, e o exemplo do README usa o qwen3.8-flash. O driver de macOS vem do projeto trycua/cua.
Nada disso roda em GPU local. O paper avalia modelos por API e não informa requisitos de hardware, e os pesos de um modelo próprio do projeto, o GCUA, aparecem no repositório só como lançamento futuro. Eu não rodei o código: esta leitura vem do paper e do README.
Quais são os limites?
O primeiro é que nenhum modelo foi treinado: os ganhos vêm de prompt e de harness, não de pesos novos. O segundo é o teste em dispositivo real, com só quatro tarefas no macOS e uma execução por modelo. Ali o GPT-6 Astra completou 4 de 4, o Claude Opus 5 e o Qwen3.8-Max completaram 3 de 4 e o Qwen3.8-Flash, 2 de 4, segundo o paper, que avisa que isso não é um ranking. O terceiro é o tempo de parede, que não foi controlado entre modelos por causa de limites de API e filas.
Também vale desconfiar da lista de tarefas, porque o status "verificado" vem da avaliação do próprio modelo, sem checagem independente. E o repositório é novo: 35 estrelas e nenhum fork na página, então é código de pesquisa em prévia.
Minha leitura é que o resultado mais útil aqui não é a nota, e sim o padrão: dar ao modelo um interpretador em vez de um mouse. Para quem constrói agentes, esse é um teste barato de fazer no próprio fluxo de trabalho. O que me falta ver é o mesmo experimento em Linux e em sites reais, onde as interfaces mudam sem aviso, e com um modelo local de pesos abertos, para saber se o ganho de 19,6 pontos sobrevive sem a API de um laboratório.
Fontes
- OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use, arXiv, 15 out. 2026
- Tongyi-MAI/OpenGCUA, GitHub, out. 2026
Gostou? Receba o próximo
Um e-mail a cada post novo. Sem spam.