PageIndex: RAG sem banco de vetores indexa por cerca de US$ 0,001 por página
O PageIndex dispensa embeddings e deixa o modelo navegar uma árvore de seções. Indexar custa cerca de US$ 0,001 por página, mas a precisão depende do modelo de chat.
O PageIndex, projeto open-source da Vectify AI com licença MIT, troca o banco de vetores do RAG por um índice em árvore que o próprio modelo navega, e lançou na semana passada a versão 0.2.21 do SDK. O repositório soma 38,8 mil estrelas e chama a atenção de quem monta RAG sobre documentos longos, como relatórios financeiros e manuais técnicos. Entender como ele funciona ajuda a decidir quando dá para dispensar embeddings.
Qual problema o PageIndex ataca no RAG?
RAG (geração aumentada por recuperação) é o padrão em que o modelo recebe, junto com a pergunta, trechos de documentos buscados antes. O caminho comum quebra o documento em pedaços (chunking), transforma cada pedaço num vetor numérico (embedding) e, na hora da pergunta, busca os vetores mais parecidos com ela.
O README do PageIndex resume a crítica numa frase: semelhança não é relevância. Num relatório de 400 páginas, a resposta pode estar numa nota de rodapé que não se parece com a pergunta, e o trecho que se parece pode ser irrelevante. A VentureBeat deu o exemplo de quem procura como se calcula o EBITDA e recebe trechos que só repetem a sigla.
Como o PageIndex funciona, passo a passo
O processo tem duas etapas, descritas no repositório. Na primeira, ele gera uma árvore a partir da estrutura do documento: capítulos, seções e subseções, cada nó com um resumo curto. Na segunda, um modelo percorre essa árvore raciocinando, como um leitor que abre o sumário, escolhe o capítulo provável e só então lê as páginas.
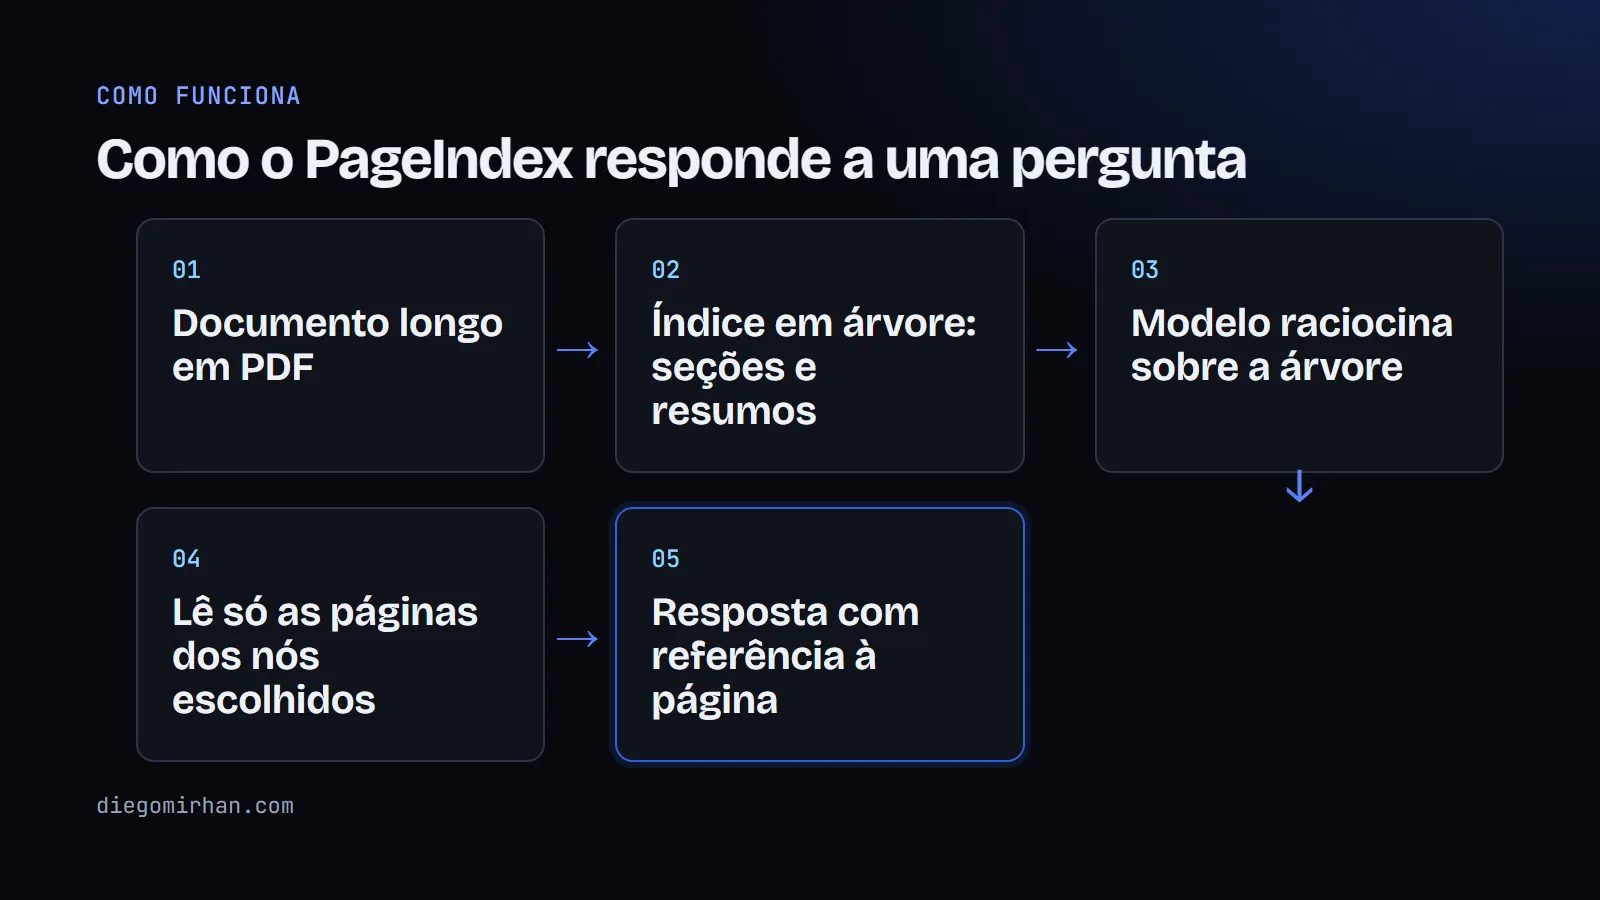
Segundo o README, a estrutura da árvore sai do layout do PDF e o modelo de indexação só resume e refina os nós, então um modelo básico basta. Quem escolhe os nós na hora da pergunta é o modelo de chat, e ali o projeto recomenda o melhor que o orçamento permitir. Como não há chunking, o caminho da busca fica visível: dá para ver quais seções foram abertas e por quê. A VentureBeat cita essa auditabilidade e a ausência de um banco de vetores para manter como vantagens.
O que os números mostram
O número de capa é a precisão de 98,7% no FinanceBench, um teste de perguntas sobre documentos financeiros. Ele vem do sistema Mafin 2.5, da própria Vectify, segundo a VentureBeat, e o README o compara com 50% de um RAG vetorial. É um resultado da empresa, não de um terceiro, e a comparação depende de como o RAG vetorial foi montado.
Os números mais úteis para quem constrói são os de custo. O README informa cerca de US$ 0,001 por página para indexar, com o modelo gpt-5.6-luna: um livro de 1.000 páginas custa pouco mais de um dólar, uma vez só. A indexação dos nove PDFs de teste, de 9 a 1.098 páginas, levou de 13 segundos a 4,5 minutos.
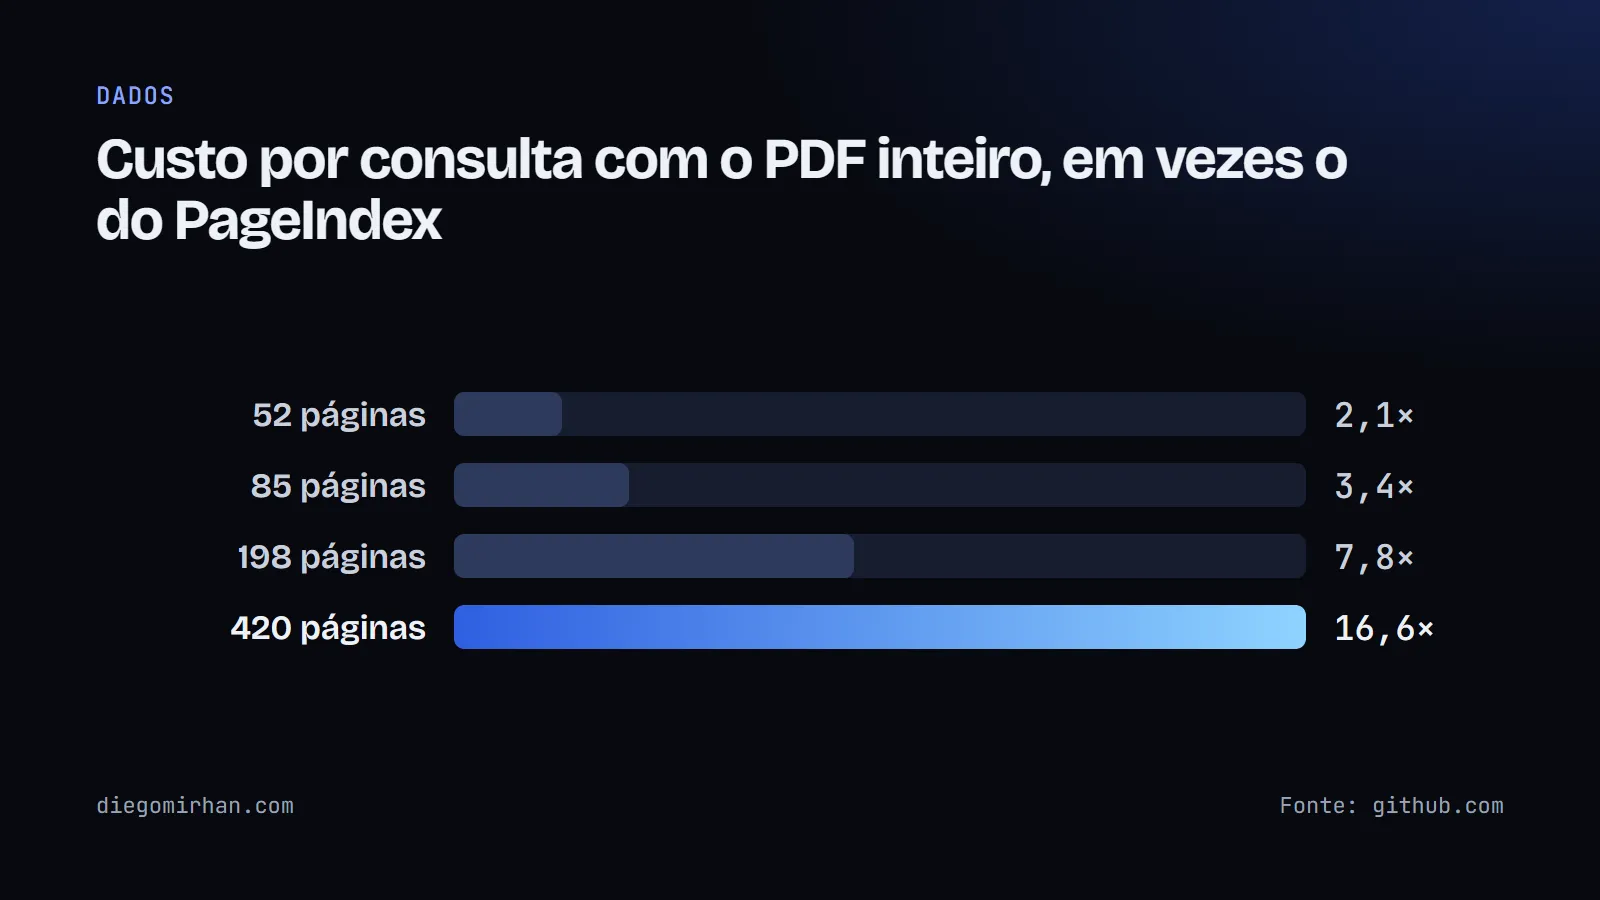
Na consulta, a alternativa é entregar o PDF inteiro ao modelo a cada pergunta. Segundo o README, isso custa 2,1 vezes mais que o PageIndex num documento de 52 páginas e 16,6 vezes mais num de 420. Com 805 páginas, o PDF já não cabe na janela de contexto.
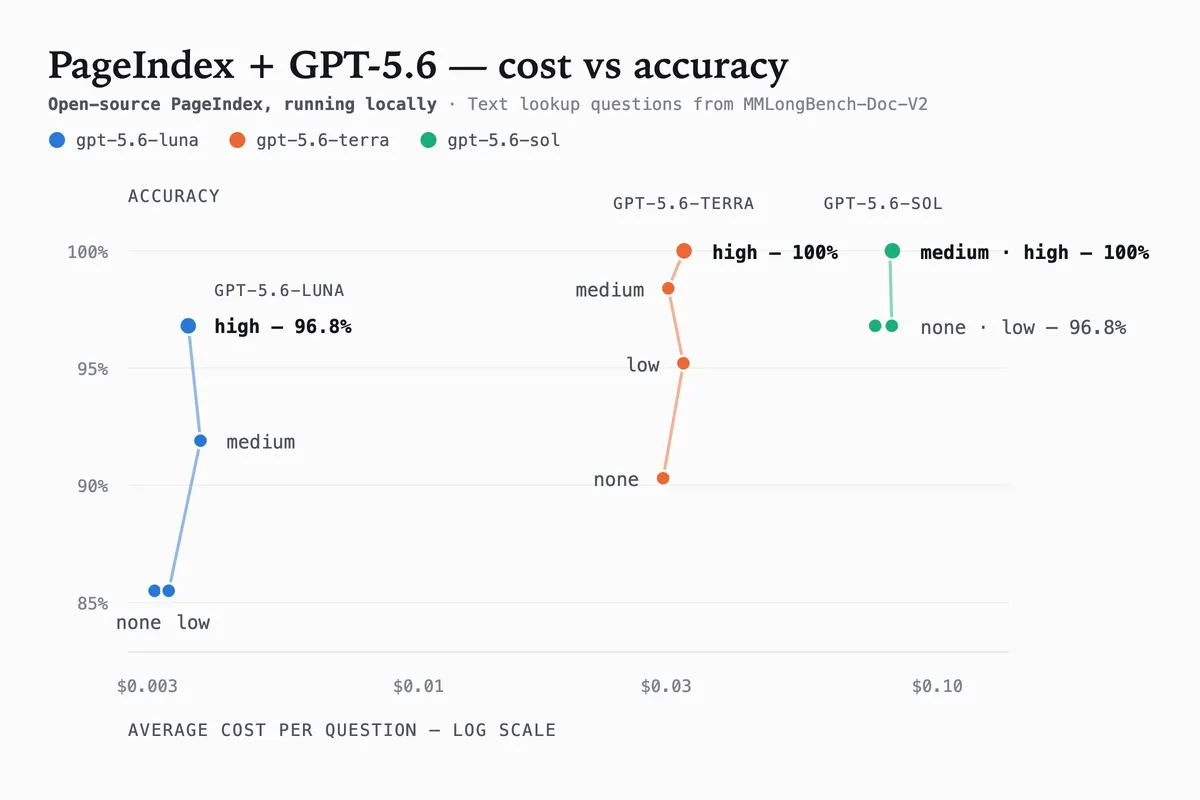
Há também um benchmark aberto da versão local, com 62 perguntas sobre 34 PDFs (1.945 páginas), todas com resposta escrita em texto corrido, sem gráfico nem tabela. O gpt-5.6-luna acertou 53 de 62 (85,5%) sem raciocínio extra e 60 de 62 (96,8%) com esforço alto, a US$ 0,0036 por pergunta em média. O gpt-5.6-sol acertou 62 de 62 com esforço médio, a US$ 0,081 por pergunta, cerca de 22 vezes mais caro que o luna em esforço alto.
Como usar o PageIndex e o que ele exige
A instalação é pip install -U pageindex. O exemplo do README cria um cliente com um modelo para indexar e outro para conversar, envia o PDF e faz a pergunta. O modo local, lançado em agosto, indexa e consulta na sua máquina com a sua chave de API, e o mesmo cliente aponta para a nuvem da Vectify com outra chave.
A versão aberta lê PDFs com texto. OCR, entendimento de imagem, citação por bloco, metadados, pastas e servidor MCP ficam na versão em nuvem, paga, segundo o mesmo README. Para trabalhar com todo um acervo, e não um documento por vez, o projeto oferece o PageIndex File System, que também é só da nuvem.
Quais são os limites?
O primeiro é o escopo. A VentureBeat diz que a abordagem não é a melhor para documentos curtos, busca semântica aberta ou perguntas simples, em que embeddings resolvem. O benchmark da própria equipe também avisa que mede só fatos em texto corrido dentro do alcance da versão aberta e que não diz nada sobre os documentos fora dele.
O segundo é que a qualidade depende do modelo de chat. A tabela do benchmark mostra a diferença entre 85,5% e 100%, e o custo por pergunta vai de US$ 0,0036 a US$ 0,081 entre o luna e o sol. O terceiro é a dependência de API: os exemplos do README usam modelos da OpenAI, e não encontrei lá instrução para rodar a busca com um modelo local pequeno. Por fim, quase todos os números vêm da própria Vectify.
Minha leitura é que o PageIndex vale um teste em qualquer caso de documento longo e estruturado, onde o RAG vetorial erra por trazer o trecho parecido e não o certo. Em coleções de textos curtos eu continuaria com embeddings, que são mais baratos de consultar. O que eu cobraria do projeto é o mesmo benchmark com um modelo aberto rodando em GPU comum, porque é aí que se descobre se navegar a árvore compensa fora de uma API grande.
Fontes
- VectifyAI/PageIndex, GitHub, 6 out. 2026
- VectifyAI/PageIndex-OSS-Benchmark, GitHub, 2026
- This tree search framework hits 98.7% on documents where vector search fails, VentureBeat, 30 jan. 2026
Gostou? Receba o próximo
Um e-mail a cada post novo. Sem spam.