Raw-RAG: busca simples no histórico bate sistemas de memória em 6 de 7 testes
Um paper de 22 de outubro compara o Raw-RAG, uma busca simples sobre o histórico bruto, com 12 sistemas de memória de agentes. Ele ganha em 6 de 7 testes.
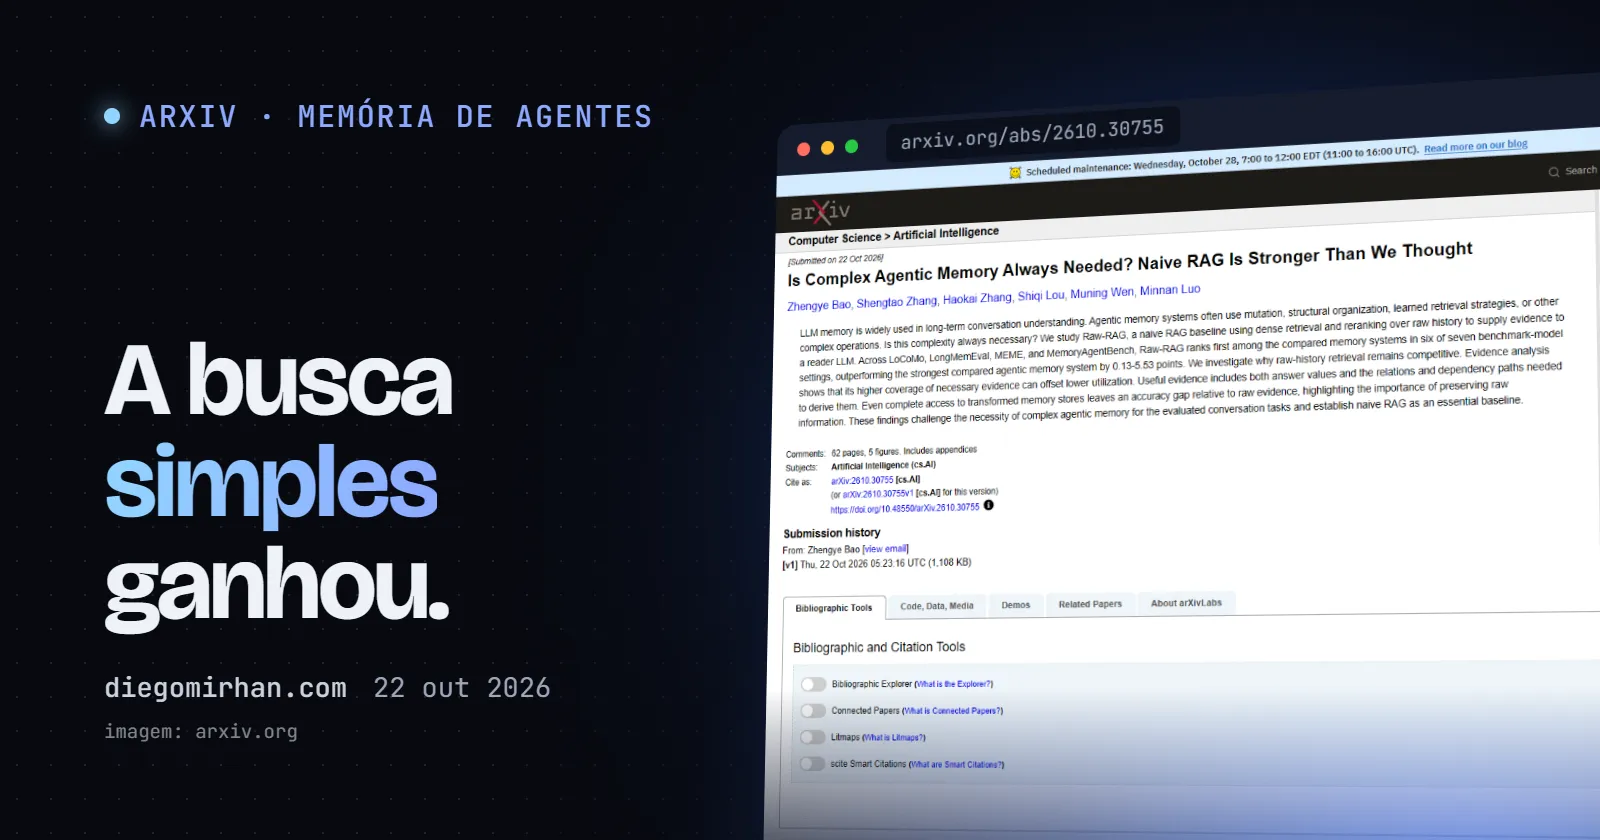
O Raw-RAG, uma busca simples sobre o histórico bruto de conversas, ficou em primeiro lugar entre os sistemas de memória para agentes em seis de sete configurações de teste, segundo um paper publicado no arXiv em 22 de outubro. Em um dos testes, o MemoryAgentBench, ele passa o melhor concorrente por 4,48 a 5,53 pontos, conforme a página do paper no Hugging Face. Para quem monta um agente com memória longa, o recado é que talvez o primeiro passo seja só indexar o que foi dito.
Qual é o problema da memória de agentes?
Um agente que conversa por semanas precisa lembrar o que o usuário disse no começo. Colocar tudo no prompt é caro e esbarra no limite de contexto, a quantidade de texto que o modelo lê de uma vez. Por isso surgiram os sistemas de "memória de agentes": programas que usam um LLM para extrair fatos da conversa, resumir, ligar entidades num grafo e até apagar ou atualizar o que já guardaram.
O paper, de Zhengye Bao e colegas, pergunta se essa engenharia toda é necessária. Os autores comparam esses sistemas, entre eles Mem0, MemOS, MemMachine e Memora, com uma linha de base deliberadamente boba, o Raw-RAG. RAG (geração aumentada por recuperação) é a técnica de buscar trechos relevantes num texto e entregá-los ao modelo junto com a pergunta.
Como o Raw-RAG funciona?
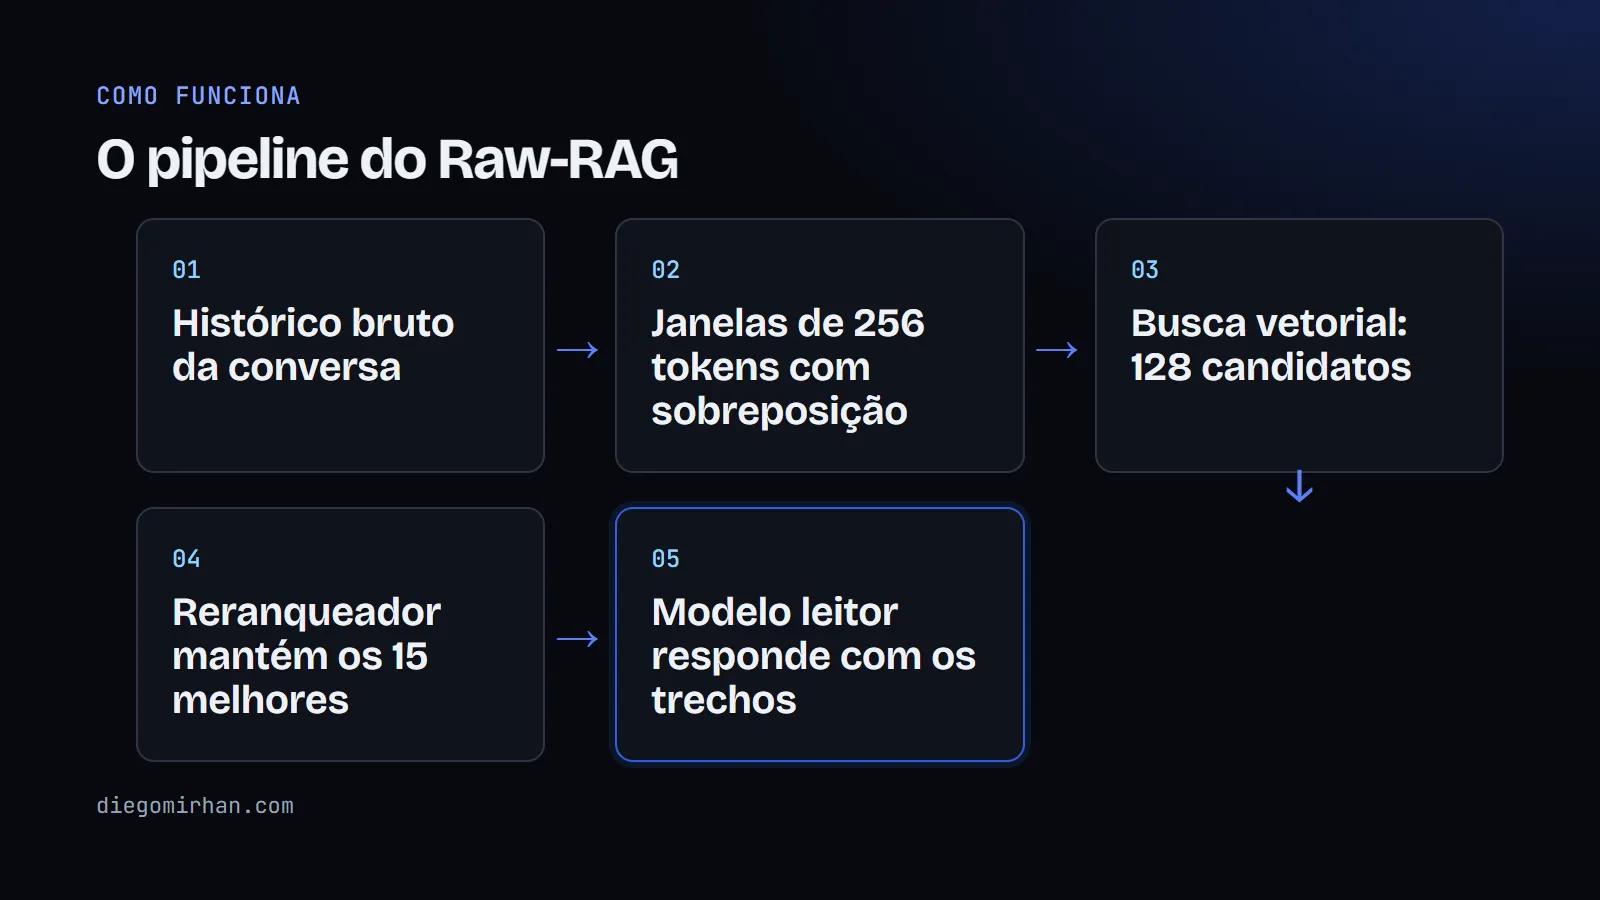
A receita é curta. A conversa inteira é cortada em janelas de 256 tokens, com 32 tokens de sobreposição entre uma e outra, e cada janela vira um vetor num índice simples. Nenhum LLM extrai fatos, resume ou monta grafo. Na hora da pergunta, o sistema busca as 128 janelas mais parecidas e um reranqueador (um modelo que reordena os candidatos olhando pergunta e trecho juntos) fica com as 15 melhores, segundo o apêndice do paper. Esses trechos vão para o modelo leitor, que responde.
O que os números mostram?
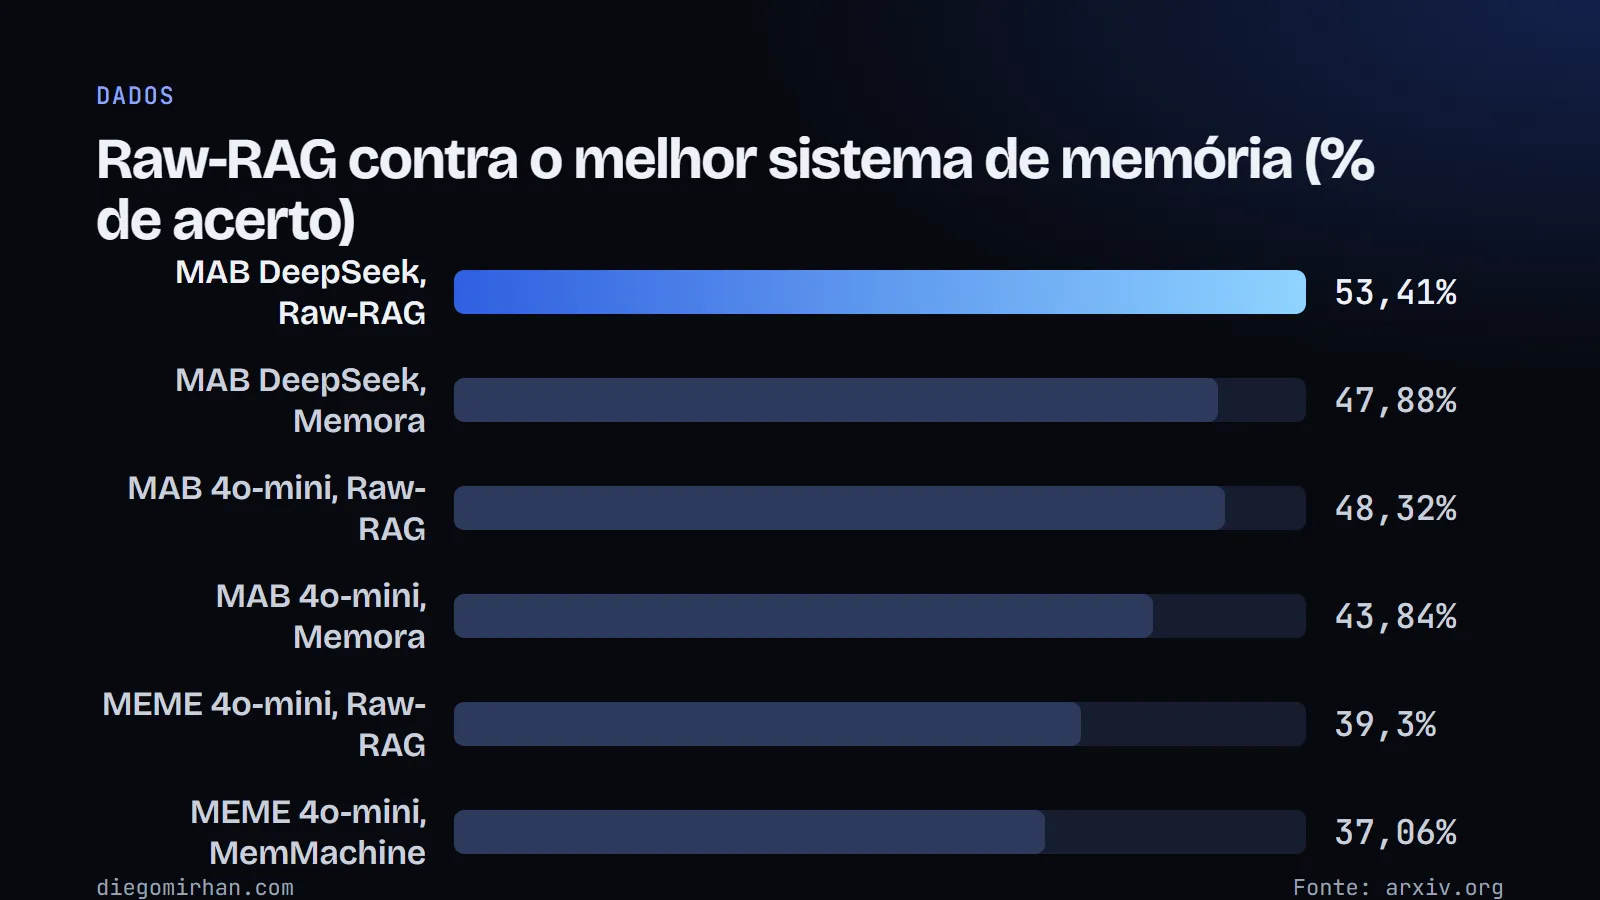
Os autores testaram quatro benchmarks (LoCoMo, LongMemEval, MEME e MemoryAgentBench) com leitores como GPT-4o-mini, GPT-4.1-mini e DeepSeek-V4-Flash. Segundo a tabela do paper, o Raw-RAG fez 53,41% no MemoryAgentBench com o DeepSeek-V4-Flash, contra 47,88% do Memora, e 48,32% com o GPT-4o-mini, contra 43,84%. No MEME com GPT-4o-mini foram 39,30% contra 37,06% do MemMachine. No LongMemEval a vantagem é de só 0,13 ponto, 87,53% contra 87,40%, o o que, na prática, é empate.
Há uma exceção que os autores mostram. No MEME com o DeepSeek-V4-Flash, o MemMachine ficou 1,52 ponto à frente, segundo a página do arXiv, e o contexto completo, sem nenhuma memória, superou o Raw-RAG por 19,98 pontos. Então o resultado é "competitivo, ou melhor", não "sempre melhor".
Por que a busca simples ganha?
A explicação do paper é cobertura de evidência: o Raw-RAG traz de volta mais dos trechos de que a resposta precisa, 45,29% no MemoryAgentBench e 76,35% no MEME, segundo a versão do Hugging Face. Quando um LLM reescreve a conversa em fatos curtos, parte da informação se perde. No teste de ablação (desligar uma peça por vez) do MemoryAgentBench, a extração de fatos atômicos derrubou a nota em 19,62 pontos, de 47,68% para 15,37% numa das medidas.
Os autores também auditaram o Mem0 no LoCoMo. Das 33.902 decisões de escrita, só 4,39% foram UPDATE ou DELETE, as operações que justificam ter uma memória que muda. Usar apenas ADD e NONE subiu a precisão de 67,36% para 69,42%. Já no Raw-RAG, tirar o reranqueador custa 3,92 pontos e devolver só um item em vez de 15 custa 11,73, de acordo com o paper. Ou seja, a parte que mais pesa é recuperar bem, e não reescrever.
Quanto custa em tempo?
Aqui a vantagem é grande. Num recorte de 10 episódios do MEME, o Raw-RAG terminou indexação e busca em 305,91 segundos, 5,1 vezes mais rápido que o segundo colocado. No BEAM-1M, uma conversa de 1.710 mensagens perto de um milhão de tokens, a indexação acumulada levou 0,33 hora contra 26,95 horas do Memora, segundo a página do paper. Quem paga por chamadas de LLM na escrita da memória economiza também em dinheiro, mas o paper mede tempo, não custo em dólares.
Dá para usar? E quais são os limites?
Aqui está a parte menos animadora. A página do arXiv e a do Hugging Face não apontam um repositório com o código do Raw-RAG. O que existe é o repositório do MEME, o benchmark, com código em licença MIT, dados em CC BY 4.0 e implementações de seis sistemas de memória. O Raw-RAG, porém, é simples o bastante para reproduzir com os parâmetros do apêndice: janelas de 256 tokens, 128 candidatos, 15 trechos. Eu não rodei nada disso; esta leitura vem do paper.
Os limites que os próprios autores listam pesam. Os testes são conversas offline em benchmarks públicos, sem agente interativo nem multimodal. Os resultados cobrem poucos modelos e tamanhos de histórico, e dependem da capacidade do leitor, então um modelo mais fraco pode mudar o quadro. O histórico bruto também cresce sem parar e traz questões de privacidade, já que nada é esquecido.
Minha leitura é que o paper vale como aviso metodológico: quem propõe um sistema de memória deveria mostrar que ele bate um RAG com reranqueador antes de vender a complexidade. No meu projeto, o PolyRAG, a lição seria testar a versão bruta primeiro. Aposto que a memória mais elaborada continua útil quando o agente precisa agir sobre o estado, apagando dados a pedido do usuário, por exemplo. Para responder perguntas sobre o passado, sem essa exigência, eu começaria pelo índice simples e só adicionaria camadas se a medição pedisse.
Fontes
- Is Complex Agentic Memory Always Needed? Naive RAG Is Stronger Than We Thought, arXiv, 22 out. 2026
- Página do paper no Hugging Face, Hugging Face, 22 out. 2026
- MEME-public, GitHub, out. 2026
Gostou? Receba o próximo
Um e-mail a cada post novo. Sem spam.