TokenRouter: servidor que divide a resposta entre dois LLMs, com até 64 vezes mais vazão
O TokenRouter, aceito no NeurIPS 2026, deixa um LLM pequeno e um grande dividirem a resposta token a token, com de 2 a 64 vezes mais vazão que o estado atual.
O TokenRouter, paper aceito no NeurIPS 2026 e publicado no arXiv em 8 de outubro, é um sistema de serviço que deixa um modelo pequeno e um grande dividirem a mesma resposta, token a token, com de 2,01 a 64,15 vezes mais vazão que as implementações atuais. O código está no GitHub. Para quem pensa em rodar um modelo pequeno por padrão e chamar o grande só nos passos difíceis, é o primeiro servidor feito para isso.
Qual problema o TokenRouter resolve?
Rotear é decidir qual modelo responde. O jeito comum é rotear a pergunta inteira: perguntas fáceis vão para o modelo barato, as difíceis para o caro. O roteamento por token vai mais fundo. A cada passo da geração, uma regra decide se o próximo token sai do modelo pequeno ou do grande, e a resposta final mistura os dois. Segundo o paper, trabalhos recentes mostram ganhos grandes de custo e qualidade com essa abordagem.
O gargalo está em servir. Servidores como o SGLang e o vLLM (os dois mais usados para rodar LLMs em produção) assumem um único modelo, em que todas as requisições avançam juntas a cada passo de decodificação. O texto completo do paper lista três problemas quando há dois modelos no meio.
O primeiro é a dessincronização de passos: o modelo pequeno é muito mais rápido por passo, mas o passo do lote espera o mais lento, e o rápido fica parado. O segundo é o atraso de admissão: a requisição que troca de modelo chega quando o destino está ocupado, espera, e os lotes se fragmentam. O terceiro é de engenharia, porque os servidores não têm uma interface para decidir o modelo a cada passo.
Como o TokenRouter funciona
A ideia tem um nome no paper: programação centrada na requisição, execução centrada no modelo. Quem usa escreve a lógica de roteamento como se existisse uma requisição só. O sistema cuida do resto.
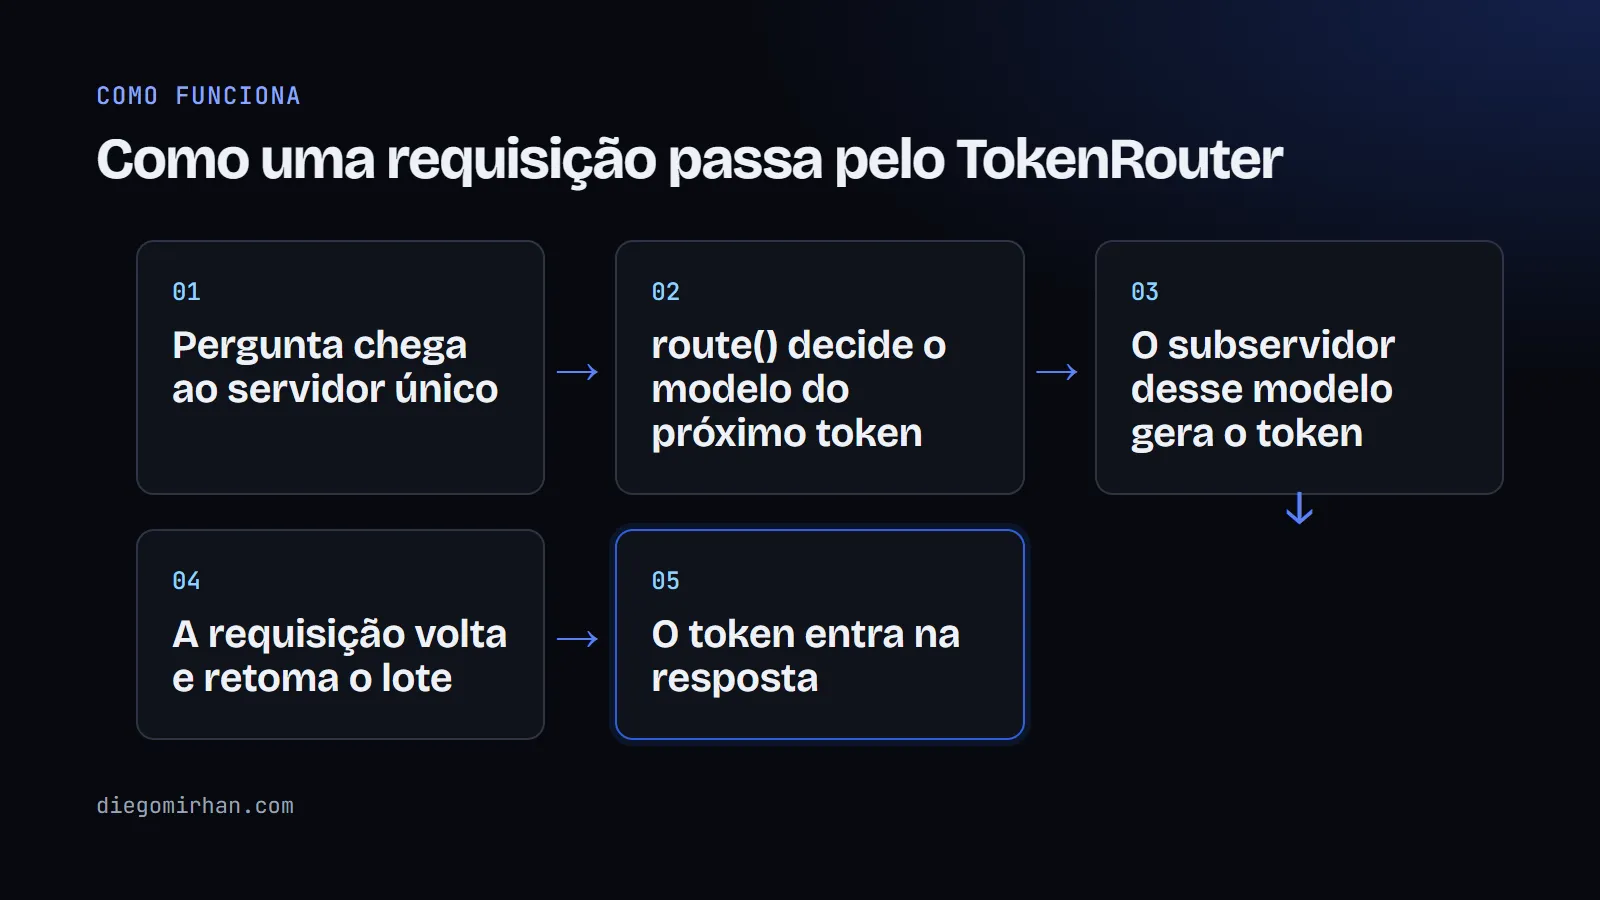
Por baixo, cada modelo roda como um subservidor autônomo, com agendador e cache de chaves e valores (KV cache, a memória do que o modelo já leu) próprios. Por fora, o conjunto aparece como um servidor só, com a mesma interface de um servidor de modelo único, segundo o paper. Um terceiro laço, entre modelos, deixa a requisição sair do lote local e voltar quando o par responde. Um estado "pendente" evita refazer a busca de prefixo e a alocação de cache, então trocar de modelo custa pouco mais que anexar um token.
A segunda peça é o agendador de lote atrasado. Em vez de lançar o lote assim que chega uma requisição, ele espera o buffer chegar a um limiar B. O paper modela o roteamento como uma cadeia de Markov (um modelo de probabilidade em que o próximo estado depende só do atual) e calcula o B que maximiza a vazão. A conta assume que o número de tokens entre dois envios segue uma distribuição geométrica. Os autores dizem que isso vale para a maioria dos algoritmos de roteamento por token e deixam os casos que fogem disso para trabalho futuro.
Do lado do desenvolvedor, o README pede três funções por modelo: route(), que devolve o nome do modelo de cada requisição, send() e receive(). Elas ficam numa subclasse de BaseTokenRoutingScheduler, registrada no SCHEDULER_REGISTRY.
O que os resultados mostram
O teste rodou num servidor com oito GPUs A100 de 80 GB, segundo o paper. Para dois modelos, o pequeno ficou em uma GPU e o grande em duas, com tensor parallelism (o modelo dividido entre placas). Os algoritmos CITER, R2R, R-Stitch e Co-LLM alternaram entre o Qwen3-0.6B e o Qwen3-32B, e o ME usou também o Qwen3-8B. As cargas foram raciocínio de baixo esforço e de alto esforço, ambas no AIME 2024, e uma tarefa de agente com o SWE-Smith.
Em 15 combinações de algoritmo e carga, a vazão sobe de 2,01 a 64,15 vezes sobre a melhor alternativa, e a latência cai de 2,03 a 63,64 vezes contra um servidor padrão montado pelos autores. Com concorrência 4, o ganho sobre as implementações oficiais é de 2,73 a 21,97 vezes em vazão. A faixa é larga porque o ganho depende de quanto cada implementação original desperdiçava.
O resultado mais fácil de interpretar é a ablação do R2R com concorrência 8, que mostra de onde vem cada ganho.
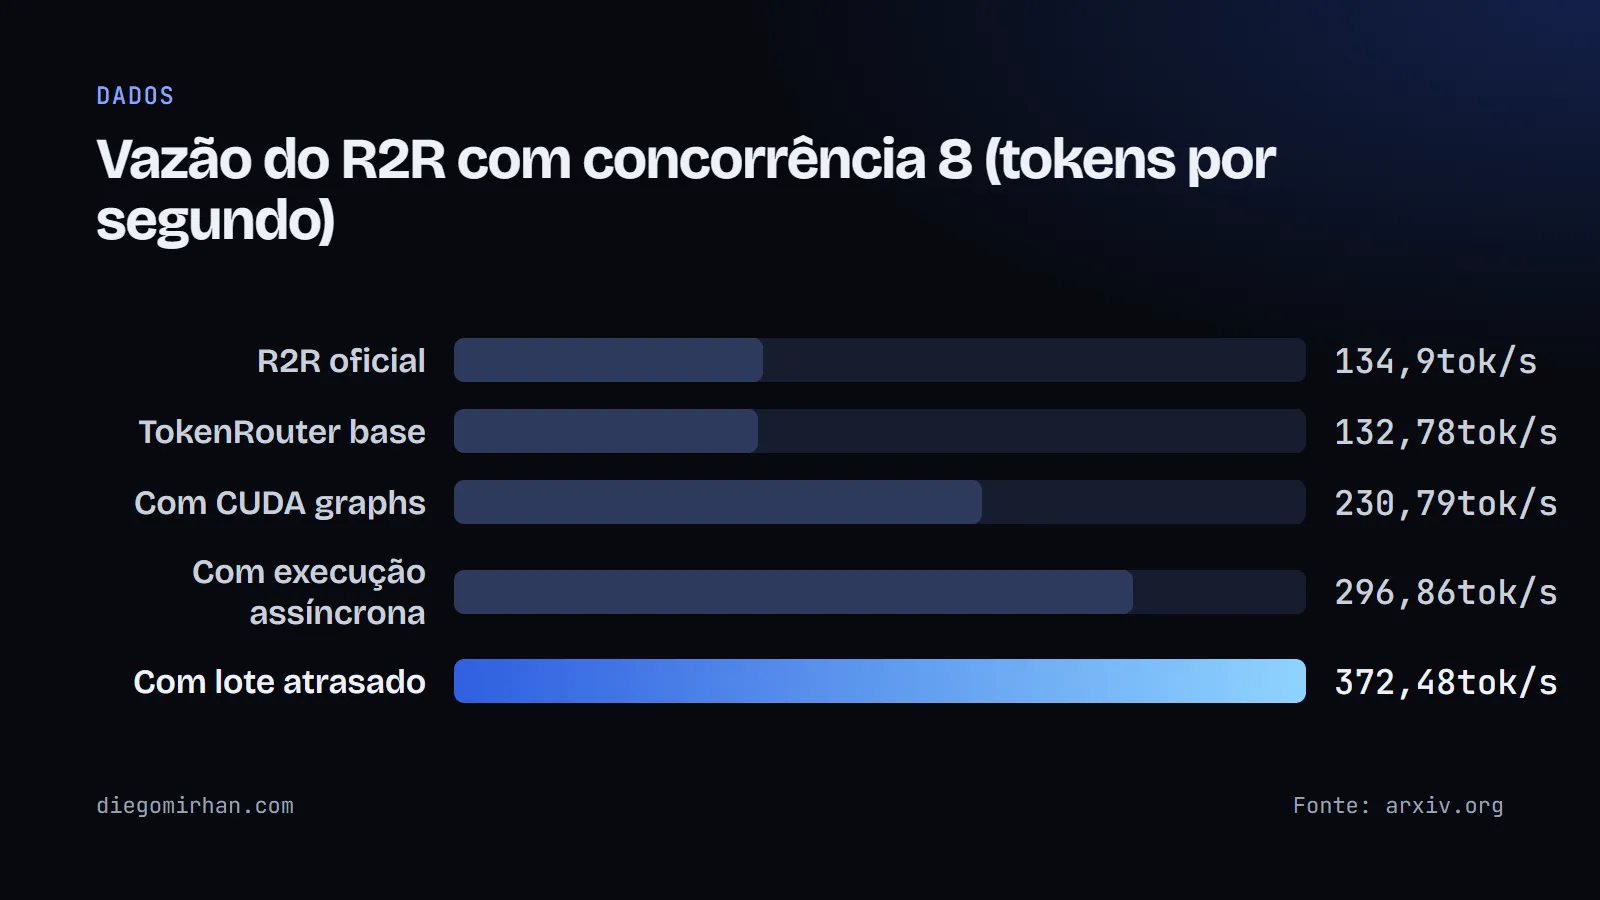
Os CUDA graphs (execução pré-gravada na GPU, que corta o custo de disparar cada operação) levam a vazão de 132,78 para 230,79 tokens por segundo, 1,71 vez a do R2R oficial, segundo o paper. A execução assíncrona sobe para 296,86 e o lote atrasado fecha em 372,48, ou 2,76 vezes o ponto de partida.
Outro número mostra o efeito em escala. Segundo o paper, de 1 a 16 requisições simultâneas, a vazão do TokenRouter cresce 8,61 vezes e cada usuário mantém 51,7% da velocidade de quando estava sozinho. O R2R oficial cresce 5,14 vezes e preserva 31,3%.
Como usar o TokenRouter
A instalação é um ambiente conda com Python 3.10 e pip install -e ., conforme o README. O servidor sobe com um comando de lançamento e um arquivo de configuração, e responde a clientes compatíveis com a API de chat da OpenAI. Há também um modo em Python, com a classe TokenRoutingEngine.
O código estende o servidor do SGLang, e o paper cita a versão 0.5.1. Os exemplos usam modelos Qwen3. O README recomenda o CUDA MPS (que deixa vários processos dividirem uma GPU) quando dois modelos ficam na mesma placa, o que indica hardware NVIDIA. Ele também não informa a licença do projeto, e isso importa antes de usar em algo comercial. Há ainda uma opção de implantação em vários nós, com um modelo por nó.
Quais são os limites?
Todo número vem dos autores, numa máquina de oito A100. Não há medição em GPU de consumo, e o par de modelos testado é Qwen3 de 0,6B e 32B. Os ganhos de até 64 vezes são contra implementações de pesquisa que não foram pensadas para servir muita gente, e não contra um servidor de produção ajustado à mão.
O paper também mede velocidade, não qualidade. A qualidade da resposta depende do algoritmo de roteamento escolhido, e o TokenRouter só garante que ele rode rápido. Minha leitura é que o valor real está no meio: depois de dois anos de artigos de roteamento que só funcionavam no laboratório, alguém entregou o servidor.
Eu testaria primeiro com um par que cabe em uma GPU comum, como um modelo de 0,6B junto de um de 8B, antes de pensar em 32B. Só vale a pena se o seu gargalo for custo por token e você já tiver um algoritmo de roteamento com qualidade comprovada no seu tipo de tarefa. Se não tiver, o ganho de vazão não compensa a complexidade de operar dois modelos.
Fontes
- TokenRouter: Efficient Serving System for Token-Level LLM Routing, arXiv, 8 de outubro de 2026
- TokenRouter: texto completo em HTML, arXiv, 8 de outubro de 2026
- thu-nics/TokenRouter, GitHub, outubro de 2026
Gostou? Receba o próximo
Um e-mail a cada post novo. Sem spam.