Trial by Trace: 31,1% das execuções passam mesmo com falha no harness de agentes
Um paper de 23 de outubro testa quatro harnesses e nove modelos em 95 tarefas. A nota de harness vai de 59,8% a 72,0%, e a tarefa passa mesmo com falha.
O Trial by Trace, um paper do arXiv de 23 de outubro, é um benchmark que avalia o harness de um agente, a camada de software em volta do modelo, e não o modelo em si. Em 3.420 execuções com quatro harnesses e nove modelos, 31,1% das execuções cumpriram a tarefa mesmo falhando em pelo menos um critério de confiabilidade do harness. Para quem monta ou escolhe um agente de código, o recado é que "a tarefa passou" esconde parte do que deu errado no caminho.
Qual é o problema que o paper ataca?
Harness é o programa que cerca o modelo de linguagem: ele monta o contexto, chama ferramentas, pede aprovação, guarda logs e decide quando o trabalho acabou. Claude Code e Codex são exemplos. A maioria dos benchmarks de agentes troca o modelo e mantém o harness fixo, ou o contrário, e olha só o resultado final: a tarefa foi resolvida ou não.
Os autores argumentam, no resumo do paper, que esse resultado final mistura duas coisas. Um agente pode acertar a tarefa porque o modelo contornou uma falha do harness, e o placar não registra o contorno. Já o lado oposto, um harness correto que recebe um modelo fraco, também não aparece separado. O trabalho propõe medir os dois lados de forma independente.
Como o benchmark funciona?
O TraceTrial-Bench tem 95 tarefas de nível especialista, todas com verificação executável ou baseada em estado, ou seja, um script confere se o arquivo, o banco ou o repositório ficou no estado esperado. A confiabilidade do harness é dividida em sete componentes: contexto, execução, governança, ciclo de vida (transições de estado, recuperação e repetição segura), observabilidade, ferramentas e verificação, segundo a versão em HTML do paper.
Cada execução recebe duas notas. A camada do agente confere as ações, o espaço de trabalho e as entregas. A camada do harness confere se ele preservou a informação e executou o que prometeu, por exemplo, se escondeu segredos nos logs ou se avisou que terminou só quando terminou. Critérios mecânicos usam verificadores de cada tarefa; critérios semânticos passam por um juiz, que no paper é o DeepSeek-V4-Flash, de acordo com a mesma seção.
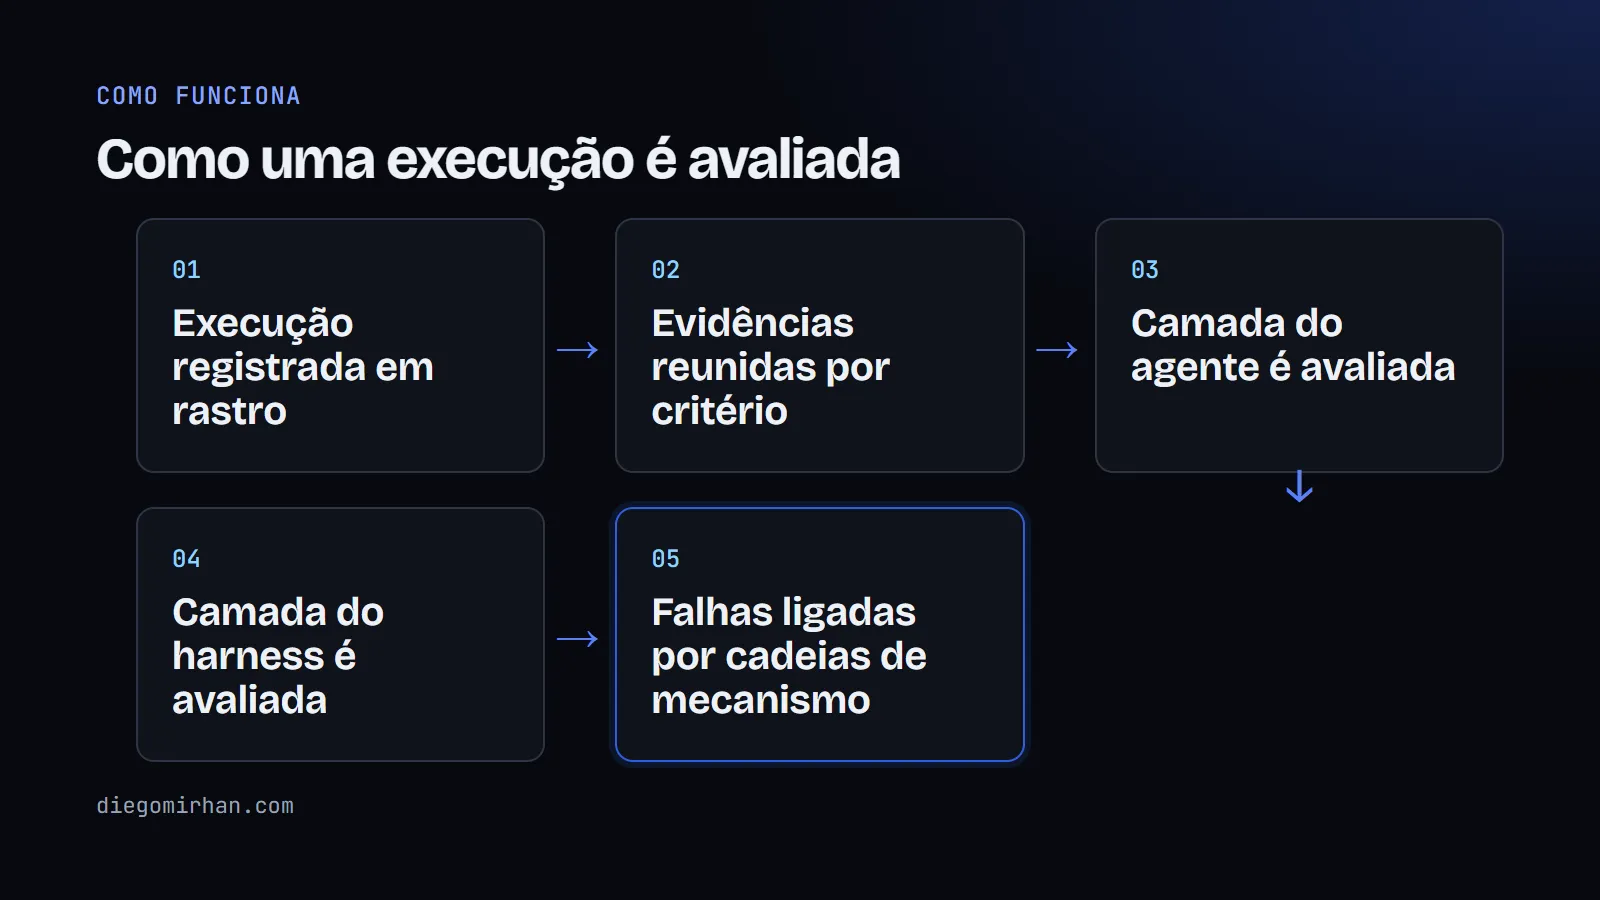
A nota combinada soma 50 pontos da camada do harness e 50 da camada do agente. Uma execução só passa no avaliador combinado se chegar a 100, conforme a descrição do método. É um critério duro de propósito.
O que os números mostram?
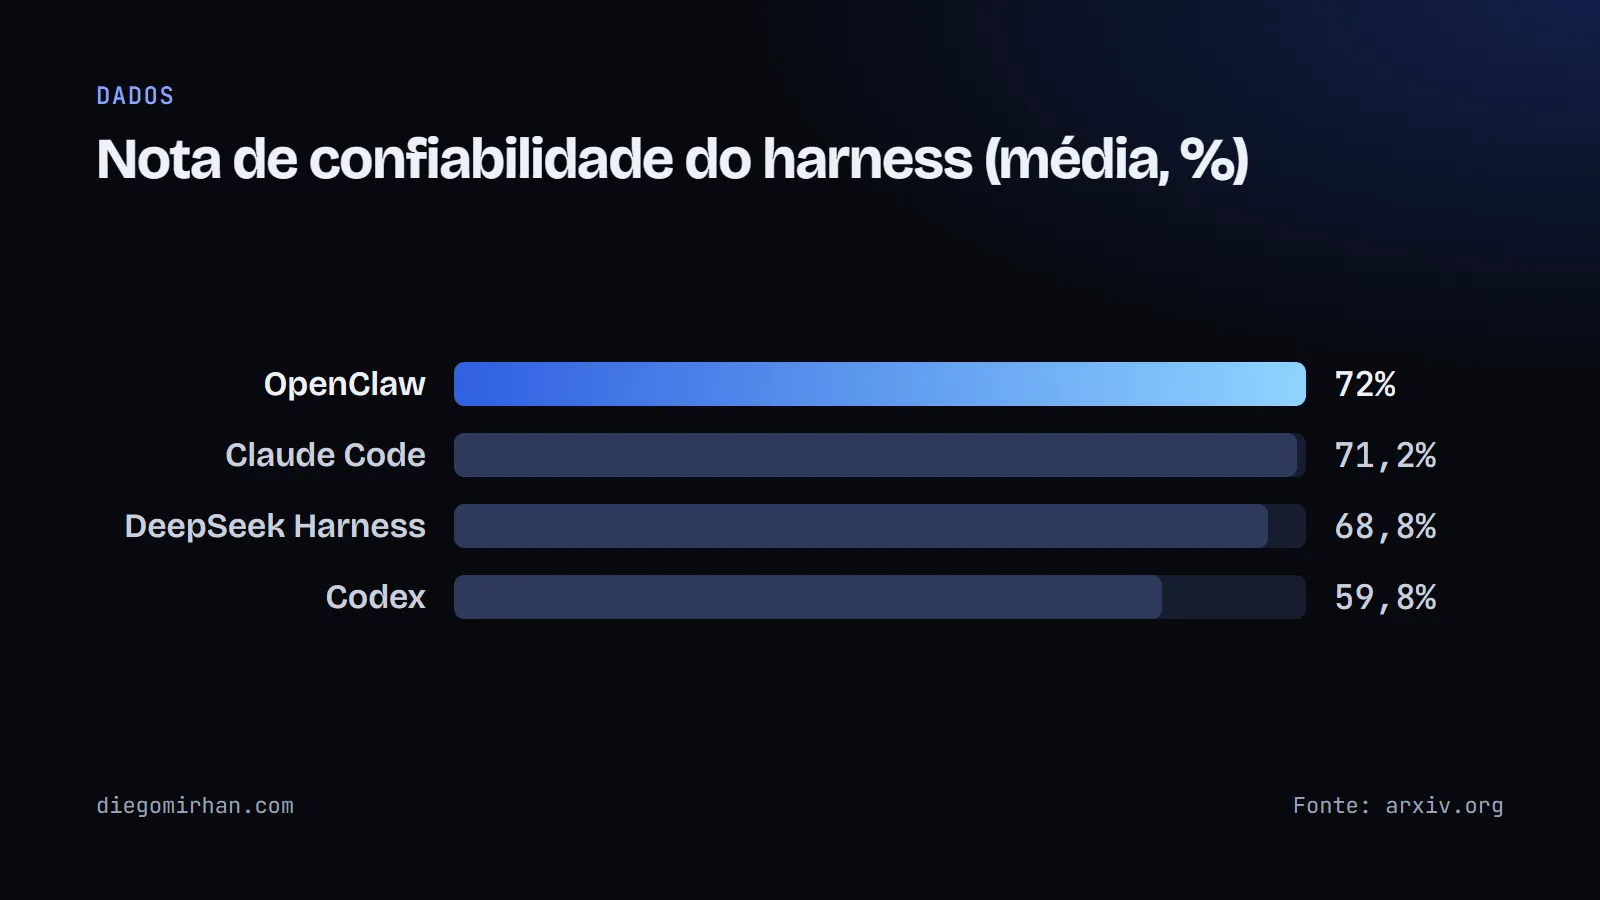
Os quatro harnesses testados foram Claude Code, Codex, o harness da DeepSeek e o OpenClaw, com nove modelos, entre eles Opus 5, GPT-5.6-Sol, Kimi K3 e GLM-5.3. A média das notas de harness vai de 59,8% no Codex a 72,0% no OpenClaw, segundo a tabela 6. O Claude Code lidera na aprovação do agente (44,0%) e na nota geral (73,5), mas o OpenClaw tem a melhor nota de harness e a maior taxa de execuções limpas.
A taxa de execuções limpas, em que todos os critérios das duas camadas passam, é baixa para todos: 11,7% no OpenClaw, 9,8% no harness da DeepSeek, 9,1% no Claude Code e 2,8% no Codex, e 8,4% no conjunto, de acordo com a tabela do paper. Em outras palavras, mais de 91 de cada 100 execuções tiveram alguma falha em algum dos dois lados.
Os mesmos dados aparecem resumidos na página do paper no Hugging Face, que repete o intervalo de 59,8% a 72,0% e os 31,1%. O texto do paper não explica como esse último número foi calculado, e eu não consegui reproduzir a conta a partir do que está publicado.
Como o paper liga a falha ao responsável?
Cada tarefa declara de antemão "elos candidatos": pares de um critério de harness e um critério de agente que podem estar ligados. Se os dois falham e a condição de ativação bate, o elo é marcado como ativado. Os autores avisam que isso é um sinal operacional, não uma prova de causa; só conta como propagação validada o elo confirmado por revisão manual da ordem dos eventos, conforme a seção 3.5.
Cada execução ganha um rótulo, como falha causada pelo harness, falha causada pelo agente ou limpa. A ideia é útil para quem depura: em vez de culpar o modelo, o rastro mostra em que passo o contexto se perdeu ou uma ferramenta devolveu algo diferente do que o agente esperava.
Dá para usar e quais são os limites?
Aqui o paper é frustrante. A página do arXiv diz que há um repositório público linkado na primeira página, mas nenhum endereço aparece no texto que consegui ler, e o Hugging Face também não lista código. Não sei dizer, então, se dá para rodar o benchmark hoje. A licença do paper é CC BY-NC-SA 4.0, que proíbe uso comercial, e isso vale para o texto, não necessariamente para o código.
Os próprios autores listam limites que pesam. Cada combinação de modelo, harness e tarefa teve uma única execução, então não há estimativa de repetibilidade. As diferenças de duração não são uma comparação controlada de velocidade. O custo do juiz fica de fora, o limite de tokens de saída do juiz varia entre 4.096, 8.192 e 32.000, e a concordância do juiz e a precisão dos elos candidatos não foram medidas, segundo a seção de limitações. As notas das duas camadas também não são estatisticamente independentes.
Minha leitura é que o número mais útil do paper não é o ranking, e sim os 31,1%. Se quase um terço das execuções "certas" falhou em algum critério do harness, então eu não confiaria num agente só porque o teste final ficou verde. Para quem escolhe entre harnesses, os 12 pontos entre Codex e OpenClaw merecem um teste próprio com as suas tarefas, já que o paper roda uma vez por célula. Aposto que avaliar o harness separado do modelo vira prática comum em benchmarks de agentes nos próximos meses, porque trocar de modelo é fácil e o harness é o que fica.
Fontes
- Trial by Trace: Benchmarking AI Agent Harnesses for Reliability and Failure Attribution, arXiv, 23 out. 2026
- Trial by Trace, versão em HTML, arXiv, out. 2026
- Página do paper no Hugging Face, Hugging Face, 26 out. 2026
Gostou? Receba o próximo
Um e-mail a cada post novo. Sem spam.