Evolving Infra serve agentes com latência até 4,1 vezes menor que a do Dynamo, da NVIDIA
Um paper do MIT propõe um servidor de LLM que troca nós entre prefill e decode em segundos e só descarta o cache que nenhum agente vai reusar.
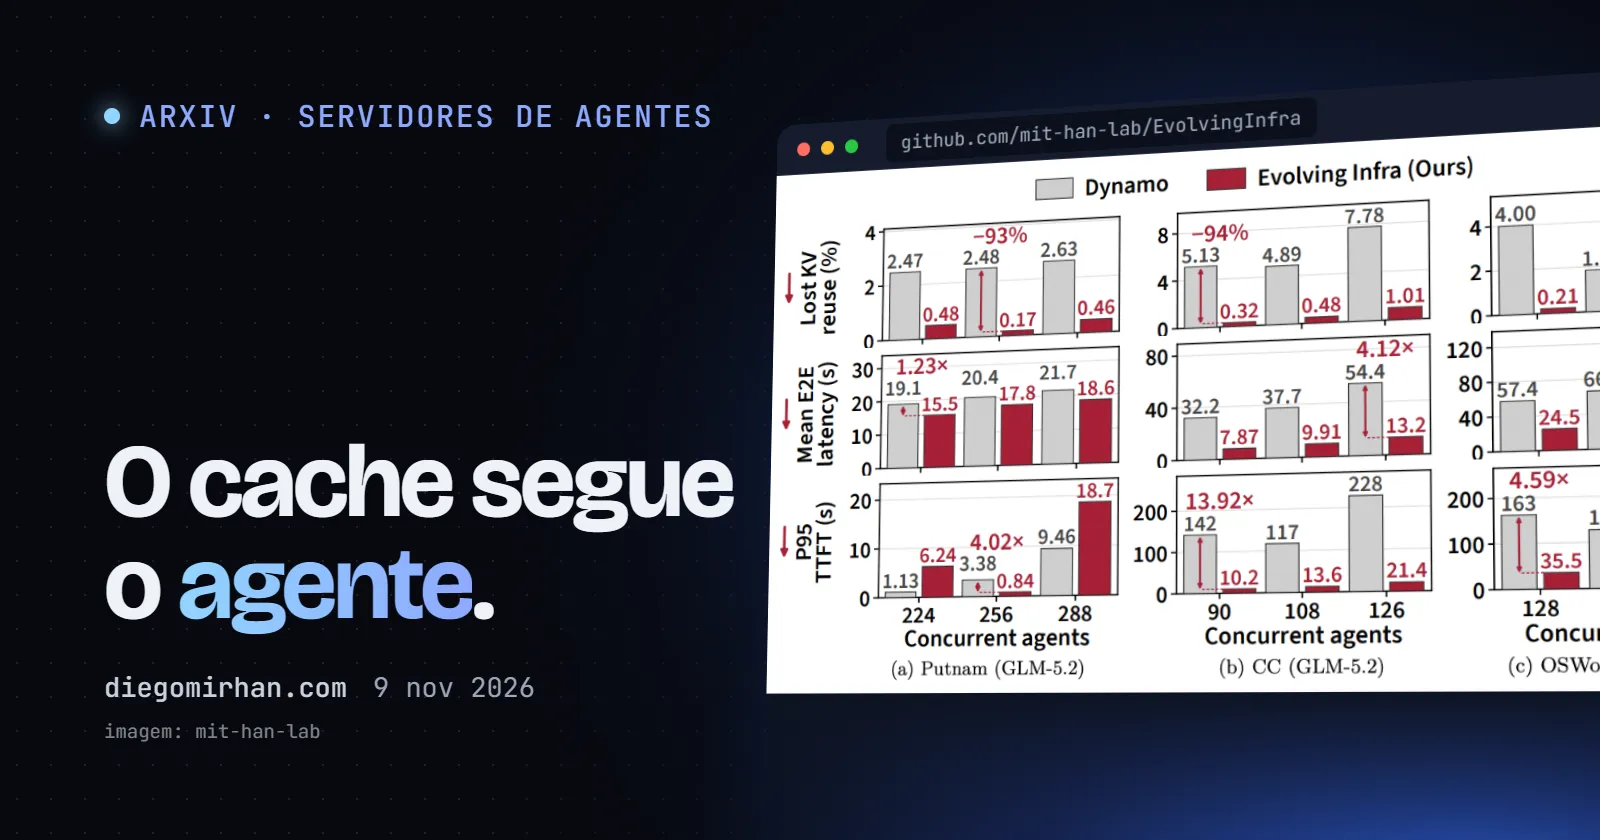
O Evolving Infra é um sistema de servir modelos de linguagem pensado para agentes, apresentado em um paper publicado no arXiv em 9 de novembro por pesquisadores ligados ao MIT, a Berkeley e à NVIDIA, entre outras instituições. Em testes com 36 GPUs GB300, ele cortou a latência média em até 4,1 vezes e o tempo até o primeiro token (TTFT) do percentil 95 em até 14 vezes, em comparação com o Dynamo, o framework de produção da NVIDIA. O ajuste acontece sozinho, sem teste prévio de configuração.
Qual é o problema de servir agentes?
Um agente de código não faz uma pergunta e espera uma resposta. Ele chama o modelo, roda uma ferramenta, devolve o resultado e chama de novo, e cada chamada repete quase todo o contexto da anterior. Por isso o servidor guarda o KV cache (as contas de atenção já feitas sobre o prompt) para não recalcular o começo a cada passo, segundo o paper.
Servidores grandes costumam separar o trabalho em duas fases, a técnica chamada de desagregação prefill-decode (PD). O prefill lê o prompt e gasta muito cálculo. O decode gera os tokens um a um e gasta muita memória. Cada fase roda em nós diferentes, e a divisão entre eles, por exemplo, quatro nós de prefill e cinco de decode, é o que os autores chamam de PD split.
Os autores apontam três falhas dos sistemas atuais com agentes, descritas na introdução do paper. A primeira é que trocar um nó de fase custa caro. No Dynamo, a troca derruba o processo do nó e leva 681 segundos em média nas medições da seção de motivação, e o nó fica fora do ar nesse tempo. O Arrow, outro sistema, troca sem reiniciar, mas perde 55,5% dos acertos de cache que teria sem trocas, porque o cache do nó trocado fica inalcançável.
A segunda falha é estimar errado a demanda. Segundo o paper, a melhor divisão fixa chega a perder 24% da vazão em alguns períodos, porque o perfil dos agentes muda ao longo do dia. Um agente de computador que anexa uma captura de tela a cada passo pesa no prefill. Um agente de matemática que gera raciocínio longo pesa no decode.
A terceira é julgar mal o que vale guardar no cache. O despejo padrão, o LRU (descarta o que foi usado há mais tempo), não distingue um ramo do agente que espera uma ferramenta de um histórico que já foi substituído por um resumo. Nos traces do Claude Code que os autores usaram, 98% do prompt coincide com o cache anterior depois de uma pausa de 359 segundos esperando um subagente, mas só 14% depois de uma compactação de 12 segundos, segundo o paper. Ou seja, o que foi usado mais recentemente nem sempre é o que será reaproveitado.
Como o Evolving Infra funciona?
A ideia central é separar duas coisas que os servidores atuais deixam coladas: qual fase cada nó executa e onde fica o cache. No Evolving Infra, todo nó roda um motor simétrico, derivado do SGLang, que sabe fazer prefill e decode. O roteador decide em tempo de execução qual nó atende cada tipo de pedido, então trocar a fase de um nó não exige reinício.
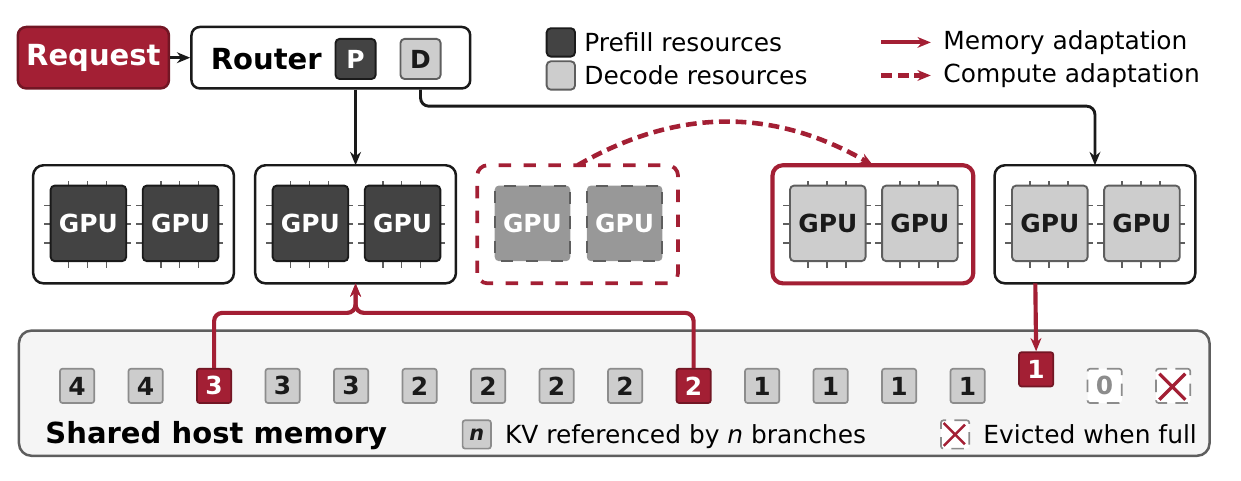
O cache fica num pool compartilhado formado pela memória do servidor (a RAM do host) de todos os nós. Como o pool não depende da fase do nó, o cache continua legível por todos quando um nó muda de função. Um diretório no roteador conta, para cada bloco de cache, quantos ramos ativos do agente ainda o referenciam. Quando o agente compacta o histórico ou um subagente termina, a contagem do bloco cai a zero. Os blocos com zero referências são os primeiros a ser despejados, conforme a descrição do sistema.
O planejador, que decide a divisão entre prefill e decode, usa dois modelos de tempo de iteração ajustados online. Durante o aquecimento, todos os nós rodam as duas fases juntas, o sistema registra o trabalho feito e ajusta os coeficientes por mínimos quadrados. O modelo de prefill separa tokens em cache de tokens novos, e é isso que evita superestimar a carga quando o agente reaproveita quase tudo. O erro médio fica abaixo de 7% fora das condições usadas no ajuste, conforme o paper. O planejador só troca a divisão quando o ganho médio previsto passa de duas vezes o erro padrão, o que evita reagir a uma rajada passageira de subagentes.
O roteador também muda. Em vez de mandar o pedido ao nó que já tem o prefixo, ele prevê o TTFT de cada nó e escolhe o menor. O nó escolhido busca o cache remoto enquanto o pedido ainda está na fila, e não só quando o prefill começa.
O que os números mostram?
Os testes usaram o GLM-5.2 e o Kimi K2.6, quantizados em NVFP4, em nove nós de quatro GPUs GB300. Três cargas de agentes foram usadas: traces reais do Claude Code, o PutnamBench (matemática, pesado em decode) e o OSWorld 2.0 (uso de computador, pesado em prefill). O comparativo é com o Dynamo v1.5.1, segundo o paper.
Com carga estável, segundo as medições do paper, o sistema entregou de 1,10 a 2,73 vezes a vazão do Dynamo e perdeu de 81% a 95% menos reaproveitamento de cache. A latência média caiu de 1,15 a 4,12 vezes, e o TTFT do percentil 95 caiu em até 13,92 vezes. Uma troca de fase leva 6,2 segundos em média, contra 754 segundos de um reinício do Dynamo nas mesmas execuções.
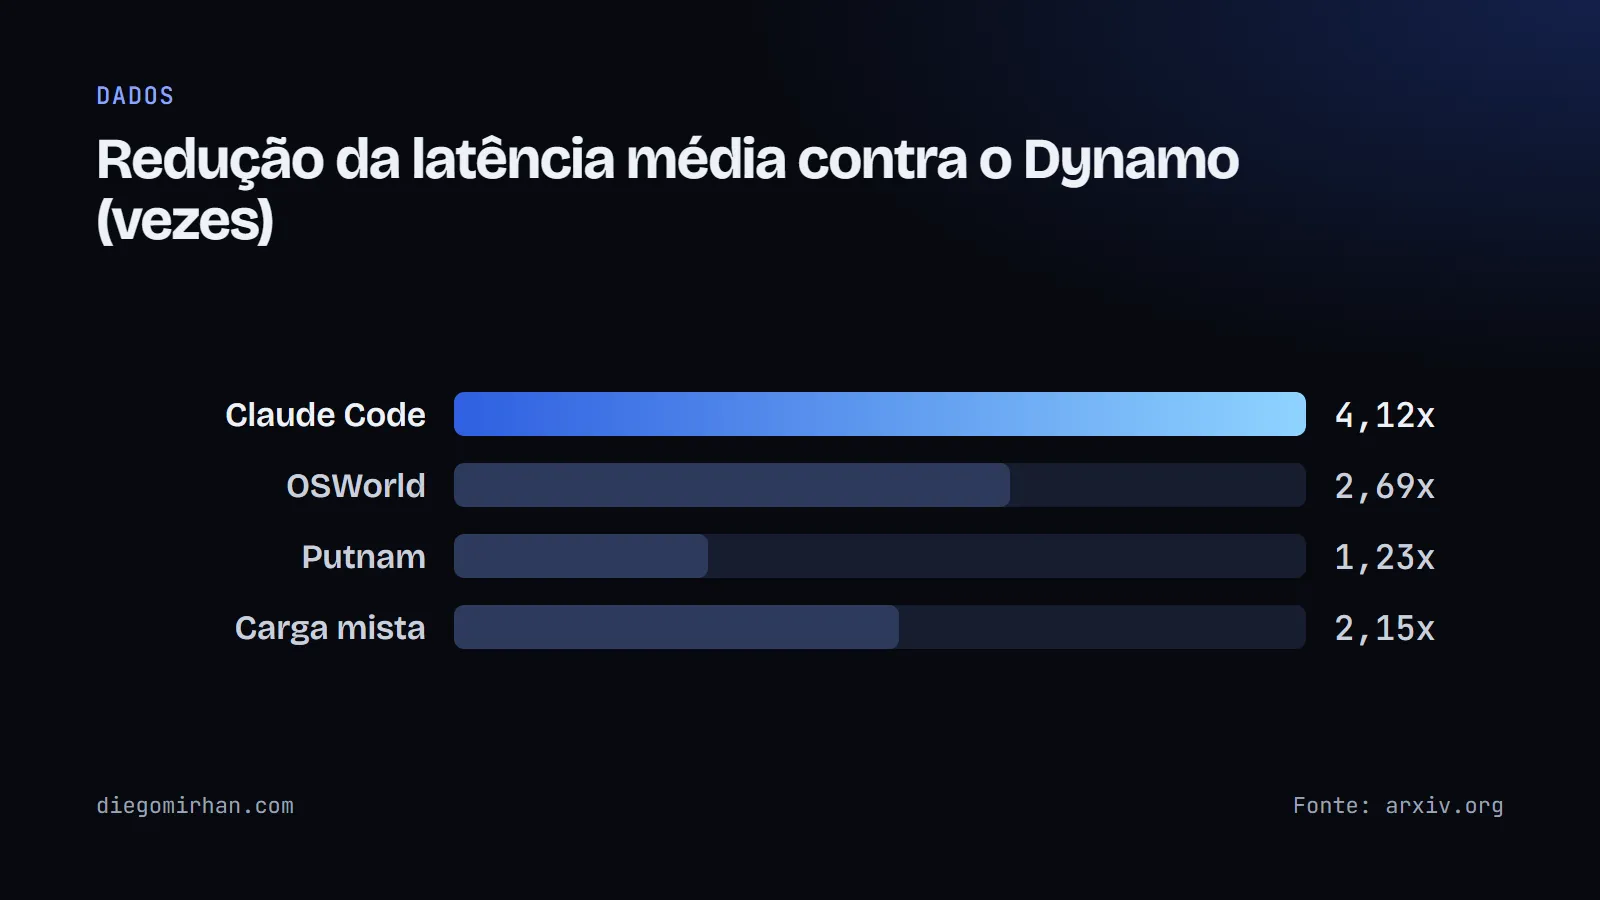
O ganho varia muito com o tipo de agente. Segundo o paper, a latência média caiu de 3,80 a 4,12 vezes no Claude Code, de 2,34 a 2,69 no OSWorld e só de 1,15 a 1,23 no Putnam. O Putnam tem um único ramo por problema e nenhum gerenciamento de contexto, o que sugere que o cache inteligente tem menos o que fazer ali. Nele, o TTFT do percentil 95 chegou a ficar acima do Dynamo com 224 e 288 agentes, porque o planejador mantém só um ou dois nós de prefill para maximizar a vazão.
Num teste com a carga mudando ao longo de três horas, descrito na seção 6.3, de matemática para uso de computador, o Evolving Infra acompanhou a melhor divisão de cada janela de 10 minutos. A latência média ficou 2,15 vezes menor que a do Dynamo e 1,33 vez menor que a da melhor divisão fixa. A vazão foi 2,14 e 1,28 vez maior, respectivamente.
O custo de se adaptar é pequeno. Ligar a adaptação online no melhor ponto fixo reduz a vazão em apenas 0,3%. Já achar a divisão boa com testes prévios custou 10.752 horas de GPU para o trace de três horas do Claude Code em 256 GPUs, e esse custo se repete para cada carga nova, segundo o paper.
Dá para usar?
O repositório tem licença MIT, mas o motor e o núcleo do roteador, derivados do SGLang, ficam sob Apache 2.0. A imagem Docker publicada é a v0.1.0, para x86_64 (H200, B300) e aarch64 (GB300). O README propõe um fluxo curioso: a instalação, o deploy e a conexão do agente são feitos por um agente de código, que segue instruções em arquivos SKILL.md.
Reproduzir o resultado do paper, segundo o README, ocupa nove nós de GPU por cerca de duas horas. Ou seja, é infraestrutura de data center, e não algo para a placa de vídeo de casa.
Quais são os limites?
O comparativo é feito com um único concorrente de produção, o Dynamo v1.5.1, e com uma reimplementação do Arrow, porque o código dele não é público. Os autores não compararam com o troca de papel em tempo de execução do SGLang, que rejeita a decodificação especulativa usada pelos dois modelos. O Llumnix não rodou nas CPUs Arm das máquinas GB300 e foi testado à parte em GPUs H200, onde entregou 12,2% menos vazão que a melhor divisão fixa, conforme o paper.
Os traces do Claude Code foram reproduzidos com saídas e durações de ferramentas fixadas nos valores gravados, então nessa carga o sistema não viu o agente reagir a respostas diferentes. Os testes mais extensos também rodaram em um só tipo de hardware, e os resultados em 3.072 GPUs vêm de simulação. Como os autores construíram o sistema e escolheram as cargas, vale esperar uma replicação independente.
Minha leitura é que a ideia mais portátil não está nos 4,1 vezes, e sim no critério de despejo: o cache deve cair quando nenhum ramo do agente vai voltar a ele, e não quando passou muito tempo desde o último uso. Quem opera agentes em escala pequena provavelmente não vai rodar nove nós de GB300, mas pode checar se o seu servidor trata uma compactação de contexto e uma pausa longa como a mesma coisa. Aposto que esse tipo de cache consciente do agente vira recurso padrão nos servidores abertos nos próximos meses, embora o paper não prove isso.
Fontes
- Evolving Infra: Agent-Adaptive LLM Serving at Scale, arXiv, 9 nov. 2026
- Evolving Infra, versão 2 em HTML, arXiv, 12 nov. 2026
- Repositório mit-han-lab/EvolvingInfra, GitHub, nov. 2026
Gostou? Receba o próximo
Um e-mail a cada post novo. Sem spam.