PoS: paper dá aos agentes de IA um estado de crença e supera os baselines em quatro testes
O PoS mantém um estado de crença validado em vez do histórico bruto e vence os baselines em quatro benchmarks, mas gasta 5 vezes mais tokens.
Um paper publicado no arXiv em 1º de outubro propõe o PoS (Progression of States), uma camada que faz agentes de IA em tarefas longas manterem um estado de crença explícito em vez de reler todo o histórico, segundo o artigo no arXiv. Nos quatro benchmarks do trabalho, o PoS ficou à frente dos baselines com os três modelos testados, e o código está aberto no GitHub. Para quem constrói agentes, o recado é que o problema de contexto pode se resolver com organização do que o agente sabe, e não só com janela maior.
Qual problema o PoS ataca nos agentes de tarefa longa?
Um agente de IA, aqui, é um modelo de linguagem que age em passos: lê uma observação, escolhe uma ação, lê o resultado e repete. Em tarefas longas, o histórico desses passos cresce e vira o contexto de cada decisão. O modelo acaba reprocessando centenas de linhas para descobrir o que já sabe e o que falta fazer.
Os autores chamam de Belief Trapping (aprisionamento de crença) o caso em que o agente segue agindo sem avançar, seja repetindo o mesmo passo, seja andando em círculo. O paper trata isso como falha do contexto: a informação certa está no histórico, mas misturada com ruído.
Como o PoS funciona, passo a passo
Em vez do histórico bruto, o PoS mantém um estado de crença (belief state) com quatro partes, conforme o texto completo do paper. A primeira é o estado do mundo relevante, descrito em entidades, estados e relações. A segunda é o objetivo e o critério de conclusão. As outras duas são lacunas ainda abertas: o que o agente não sabe (epistêmica) e o que ele ainda não fez (de realização).
A cada passo, o agente decide olhando para esse estado, para a lacuna ativa e para eventuais restrições de recuperação. Depois da ação, a observação gera uma proposta de atualização, e essa proposta só entra se passar por uma validação. O "Belief Sentinel" confere se o novo estado se contradiz por dentro ou contradiz o que foi observado.
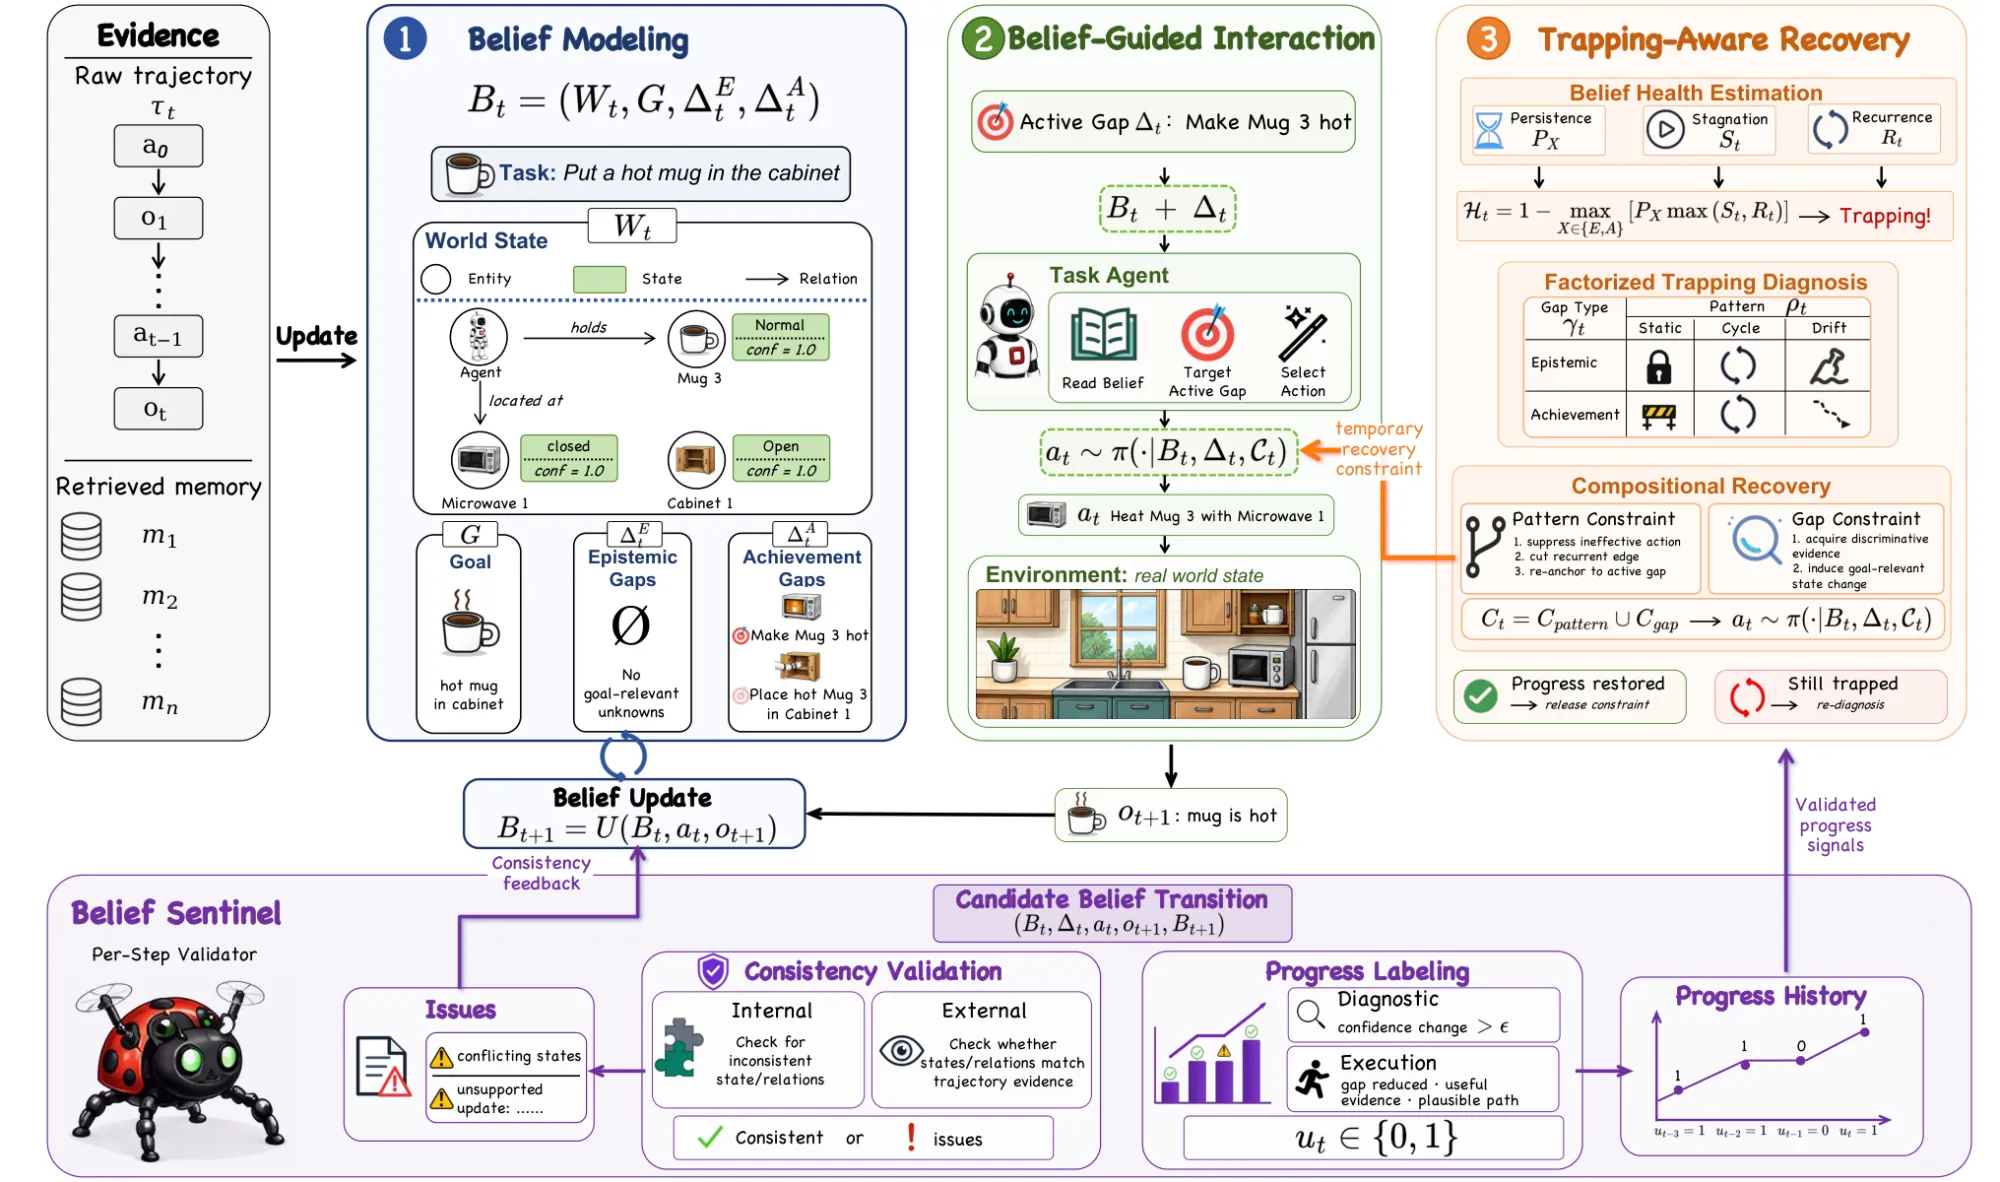
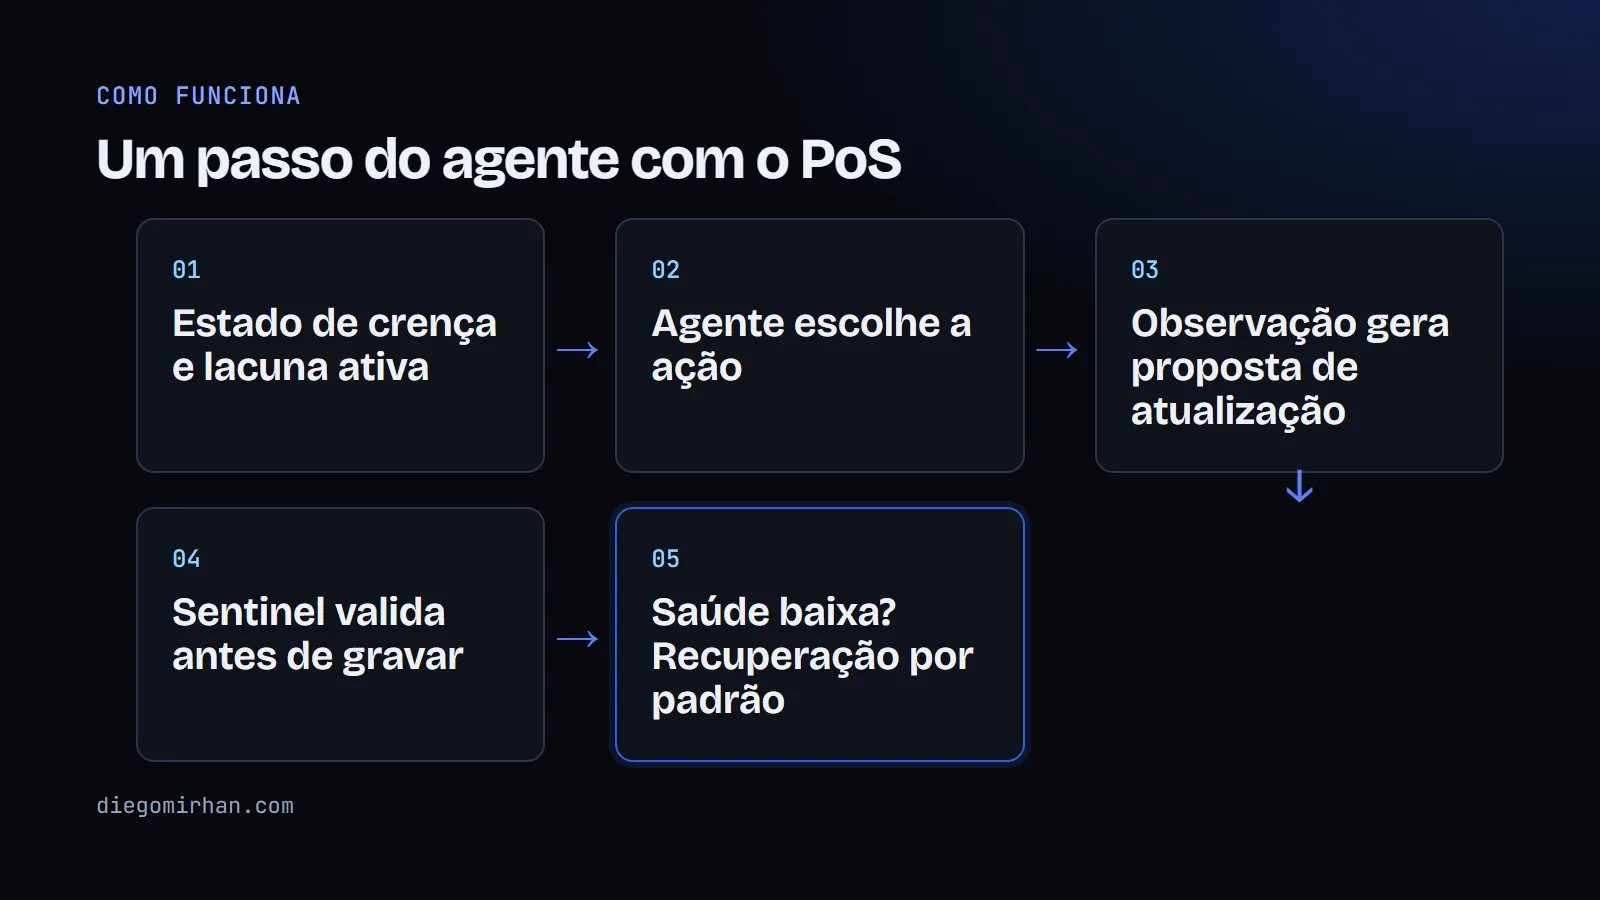
A detecção de aprisionamento usa três sinais numa janela dos últimos passos: quanto tempo as lacunas ficam abertas, quantos passos não registram progresso e quantas vezes o mesmo estado de mundo reaparece. Quando a nota de saúde cai abaixo de um limiar, o PoS classifica o padrão (parado, em ciclo ou à deriva) e o tipo de lacuna bloqueada. Cada combinação gera uma restrição diferente, como quebrar o ciclo ou exigir uma evidência que distinga hipóteses, tudo descrito no paper.
O que os números mostram
O trabalho testou quatro benchmarks: ALFWorld (134 casos de tarefas em ambiente de texto), LOCA-Bench (525 casos de fluxos com várias fontes e contexto de 8 mil a 256 mil tokens), RCA-100 (103 casos de diagnóstico de falha em microsserviços) e ClinDiag (604 casos de raciocínio clínico). Os três modelos de base foram Qwen3.7-Plus, Kimi-K3 e GLM-5.3, de acordo com o texto no arXiv.
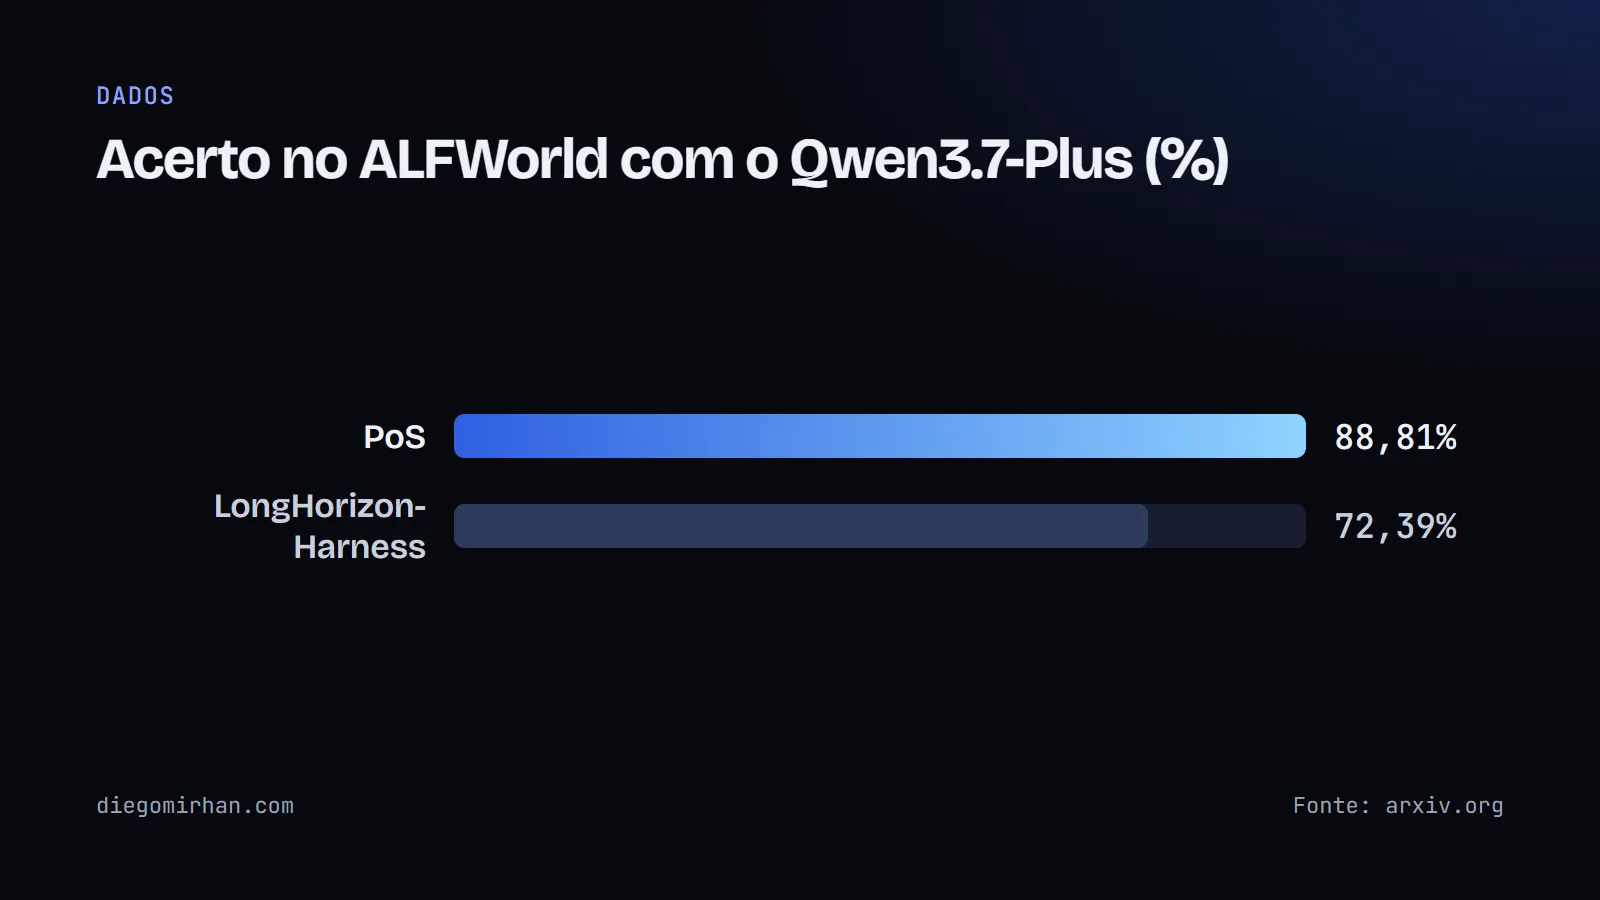
O ganho relativo sobre o melhor baseline chegou a 22,68% no ALFWorld, 7,53% no LOCA-Bench, 37,89% no RCA-100 e 11,31% no ClinDiag, segundo o paper. No ALFWorld, o PoS com o Qwen chegou a 88,81%, contra 72,39% do LongHorizon-Harness, o melhor baseline daquele teste.
O teste de escala de contexto é o mais interessante para quem usa janelas grandes. No LOCA-Bench, o histórico bruto perde desempenho conforme o contexto cresce, e o ACON, que comprime o histórico, cai mais devagar. O PoS se manteve estável de 96 mil a 256 mil tokens e ficou de 10,67 a 16,00 pontos percentuais à frente do melhor baseline em 256 mil, conforme o paper.
As ablações (retirar uma peça e medir) apontam o que importa. Sem a validação de consistência, o desempenho cai de 0,33 a 14,93 pontos, com o pior efeito nas tarefas de execução. Sem a recuperação de aprisionamento, a perda vai de 2,65 a 6,79 pontos, de acordo com o mesmo texto.
Como usar o PoS e quanto custa
O repositório traz a gestão de crenças, os baselines, as integrações com os quatro benchmarks, os prompts e a documentação. O código tem licença MIT, e os componentes de benchmark mantêm os termos próprios, segundo o repositório no GitHub. Ele pede Linux e Python 3.11, instala com pip install -r requirements.txt e roda por arquivos YAML de configuração, e a documentação recomenda o Qwen3.7-Plus pela API DashScope.
Isso quer dizer que o PoS funciona como camada em volta de um modelo e não exige treinar nada, e a página do paper no Hugging Face descreve o método como de tempo de inferência. O repositório, porém, não traz instruções para rodar com modelo local, e o paper não informa qual GPU seria necessária. O projeto é recente: tem poucas estrelas e 8 commits no GitHub, ou seja, é um código de pesquisa recém-lançado.
Quais são os limites do PoS?
O custo é o primeiro. Na tabela de custo do paper, com o Qwen3.7-Plus no RCA-100, o acerto conjunto sobe de 24,27% para 38,83%, e o consumo total de tokens fica 5,06 vezes maior por causa da manutenção das crenças. O agente que age gasta 20,9% menos tokens, mas validar e atualizar o estado custa mais do que isso. Tirar a validação economiza 35,6% dos tokens e perde 7,76 pontos de acerto.
O segundo limite é a dependência de conhecimento do domínio. Os próprios autores listam as duas restrições no paper: custo da manutenção explícita e necessidade de saber como descrever o estado em cada tarefa. Além disso, os quatro benchmarks são de texto e de diagnóstico; o paper não mostra agente que mexe em código ou em navegador.
Minha leitura é que vale testar a ideia, não o código pronto. Se você tem um agente que se perde depois de 50 passos, manter uma lista curta de fatos confirmados e de pendências, e validá-la antes de gravar, é uma mudança pequena que o paper sugere funcionar. O que eu cobraria dos autores é o mesmo número com um modelo pequeno e local, porque um custo de 5,06 vezes em tokens pesa muito mais fora de uma API.
Fontes
- Beyond Memory: Harnessing Long-Horizon Agents with Explicit Belief States, arXiv, 1 out. 2026
- Versão HTML do paper (tabelas e figuras), arXiv, 1 out. 2026
- Repositório luoyu100/PoS, GitHub, 2026
- Página do paper no Hugging Face, Hugging Face, 2 out. 2026
Gostou? Receba o próximo
Um e-mail a cada post novo. Sem spam.