Thinking Inertia: desligar o raciocínio do LLM não impede que ele raciocine
O paper Thinking Inertia mostra que desligar o raciocínio ou pedir só a resposta não zera o texto extra. Em perguntas abertas, o acerto cai cerca de 15 pontos.
O paper Thinking Inertia, aceito no NeurIPS 2026, mostra que desligar o modo de raciocínio de um modelo de linguagem não impede que ele raciocine na resposta. Em perguntas abertas, o DeepSeek-V4-Flash com o raciocínio desativado ainda mostrou inferência explícita em 99,9% das respostas. Quem usa "pense menos" para cortar custo e latência em produção precisa saber que a instrução sozinha não garante nada.
Qual é o problema com o "modo sem pensar"?
Modelos de raciocínio gastam tokens (pedaços de palavra, a unidade que as APIs cobram) escrevendo uma cadeia de passos antes da resposta final. Muita aplicação não precisa disso: classificar um ticket ou marcar uma alternativa não pede dez parágrafos de raciocínio. Por isso as APIs oferecem uma chave para desligar o pensamento, e muitos prompts acrescentam "responda só com o resultado".
O paper questiona como se mede o que "sem pensar" significa. Os sinais comuns são a chave desligada, a ausência da tag de raciocínio e uma saída curta. Os autores argumentam que nenhum deles prova que o texto antes da resposta está vazio, e propõem olhar a resposta em si.
Como os autores medem se o modelo pensou?
Cada resposta é dividida em duas partes: tudo o que aparece como texto visível antes da resposta final analisável (o "pré-resposta") e a resposta em si. A partir daí há três medidas, descritas no paper. A primeira é a taxa de pré-resposta vazia (ETR): a fração de saídas em que não há nada antes da resposta nem texto substancial depois dela. A segunda é a relevância entre a pergunta e o pré-resposta, calculada com embeddings. A terceira é a taxa de inferência explícita (EIR), em que um modelo juiz rotula se o texto contém raciocínio de fato.
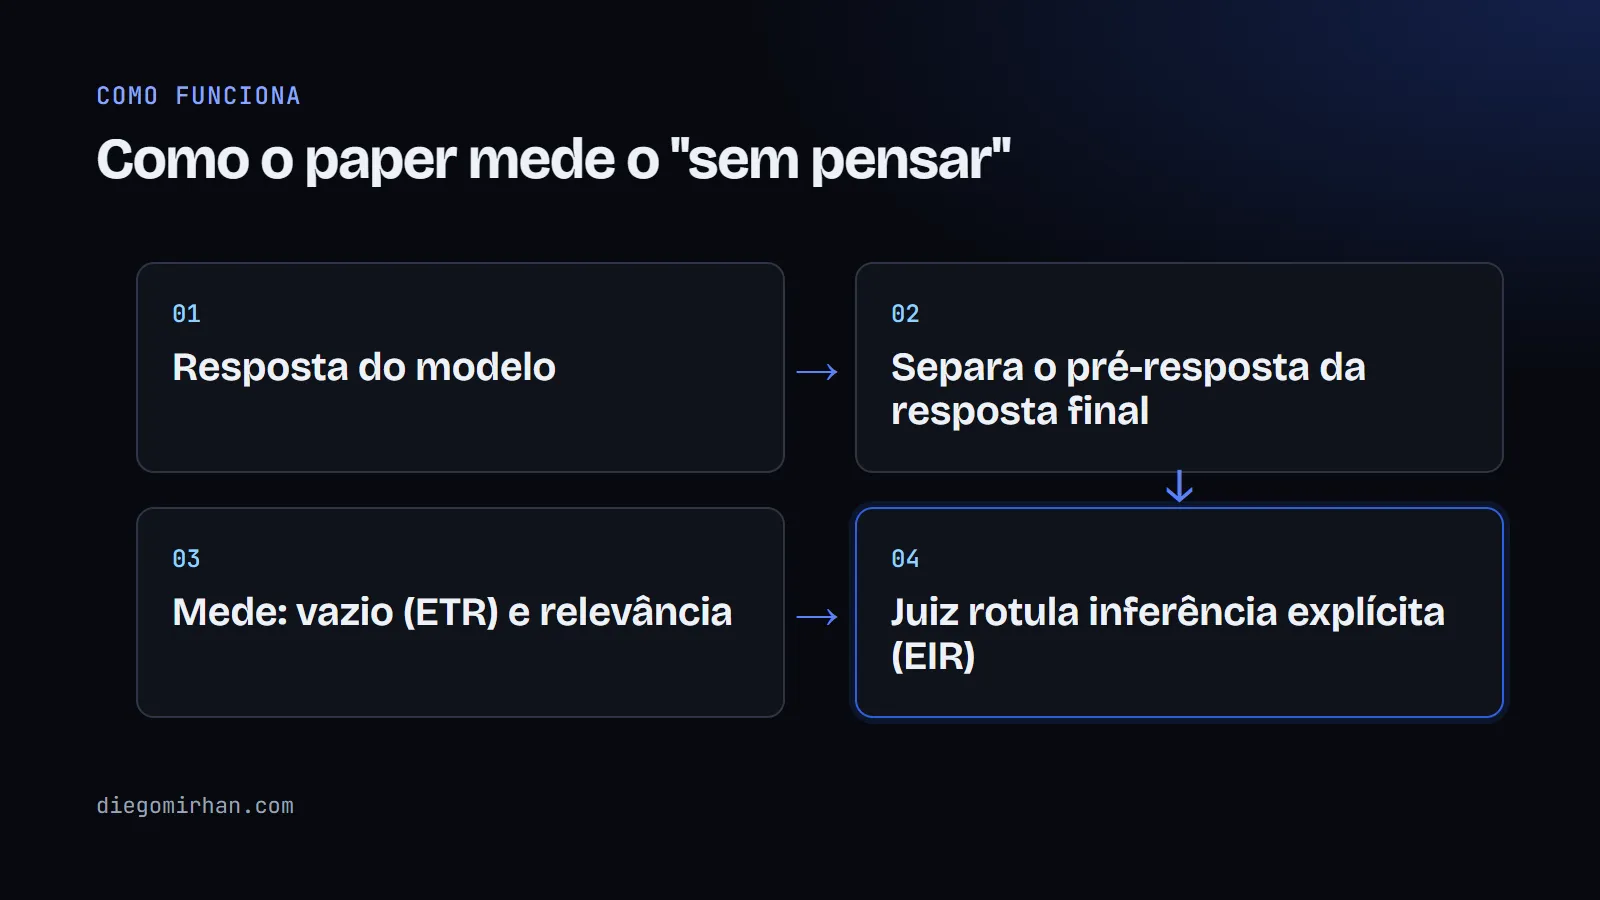
O teste usa seis intervenções, de "pensamento ligado" a "pensamento desligado" com instruções de resposta curta e com o começo da resposta já escrito pelo prompt. Foram seis modelos, entre eles Qwen3-4B, Qwen3-32B, DeepSeek-V4-Flash, GPT-5.4 e Gemini-3-Flash-Preview, em perguntas de verdadeiro ou falso, de múltipla escolha e abertas. O corpus final tem 572.688 saídas, segundo o paper. Para checar o juiz, os autores compararam 600 saídas com rótulos humanos: a concordância foi de 98,8% com o GPT-5.5 e de 96,7% com o Claude Opus 4.8.
O que os resultados mostram?
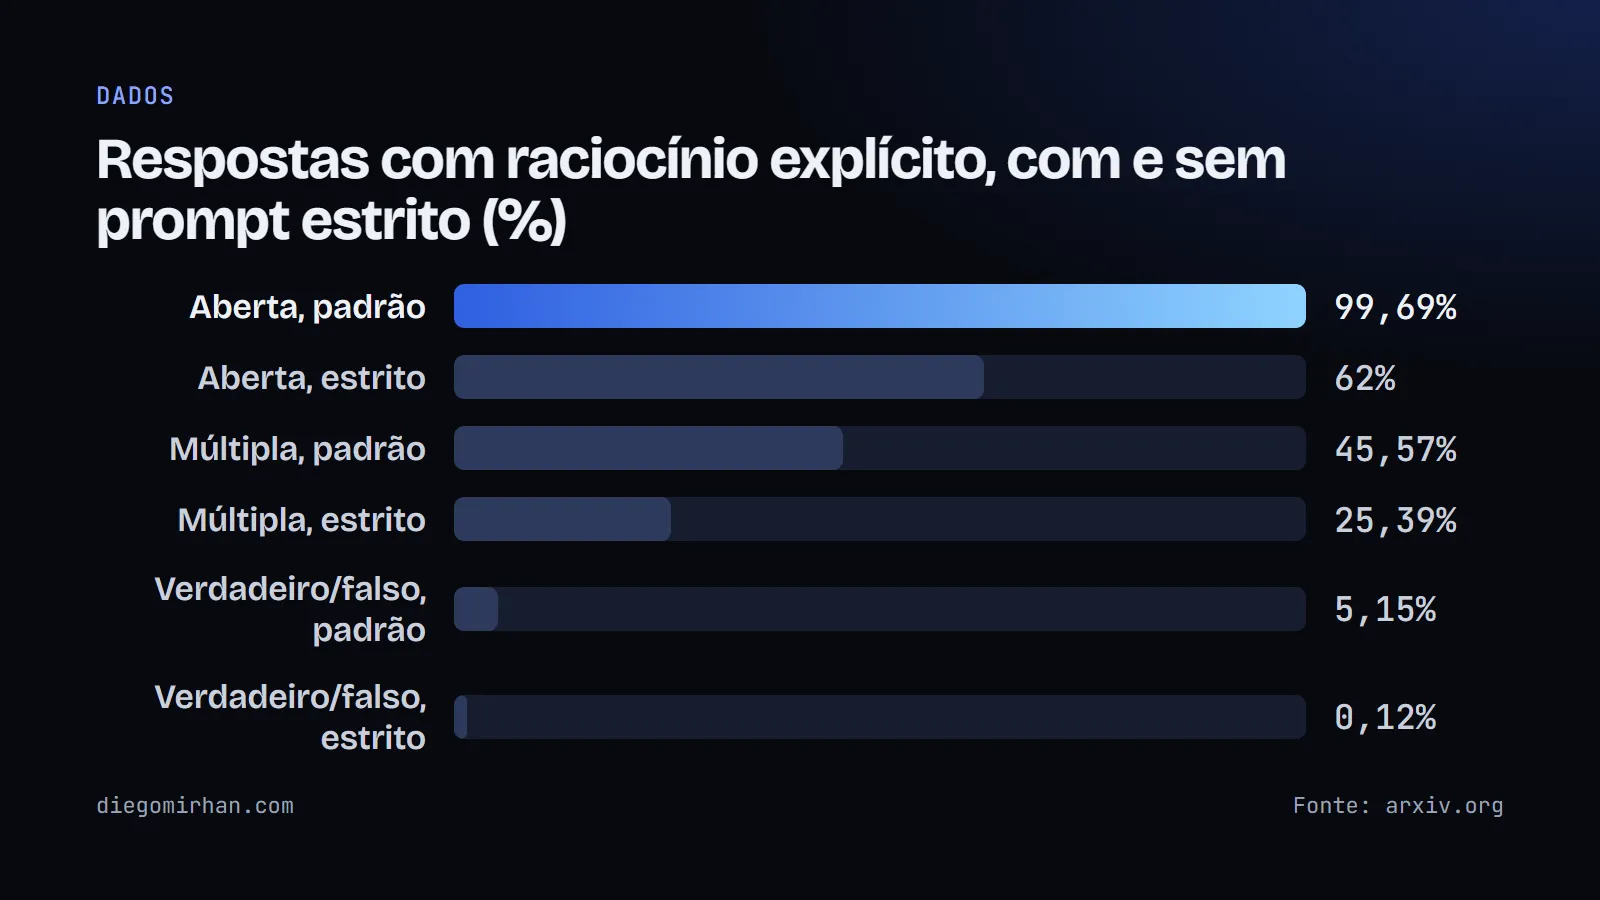
O achado central é que a inferência visível cresce conforme o espaço de respostas se abre. Com um prompt estrito de "só a resposta", a taxa de inferência explícita fica em 0,12% nas perguntas de verdadeiro ou falso, 25,39% nas de múltipla escolha e 62,00% nas abertas. Sem a instrução, os números são 5,15%, 45,57% e 99,69%. O instrumento é o mesmo e o resultado depende só do formato da pergunta.
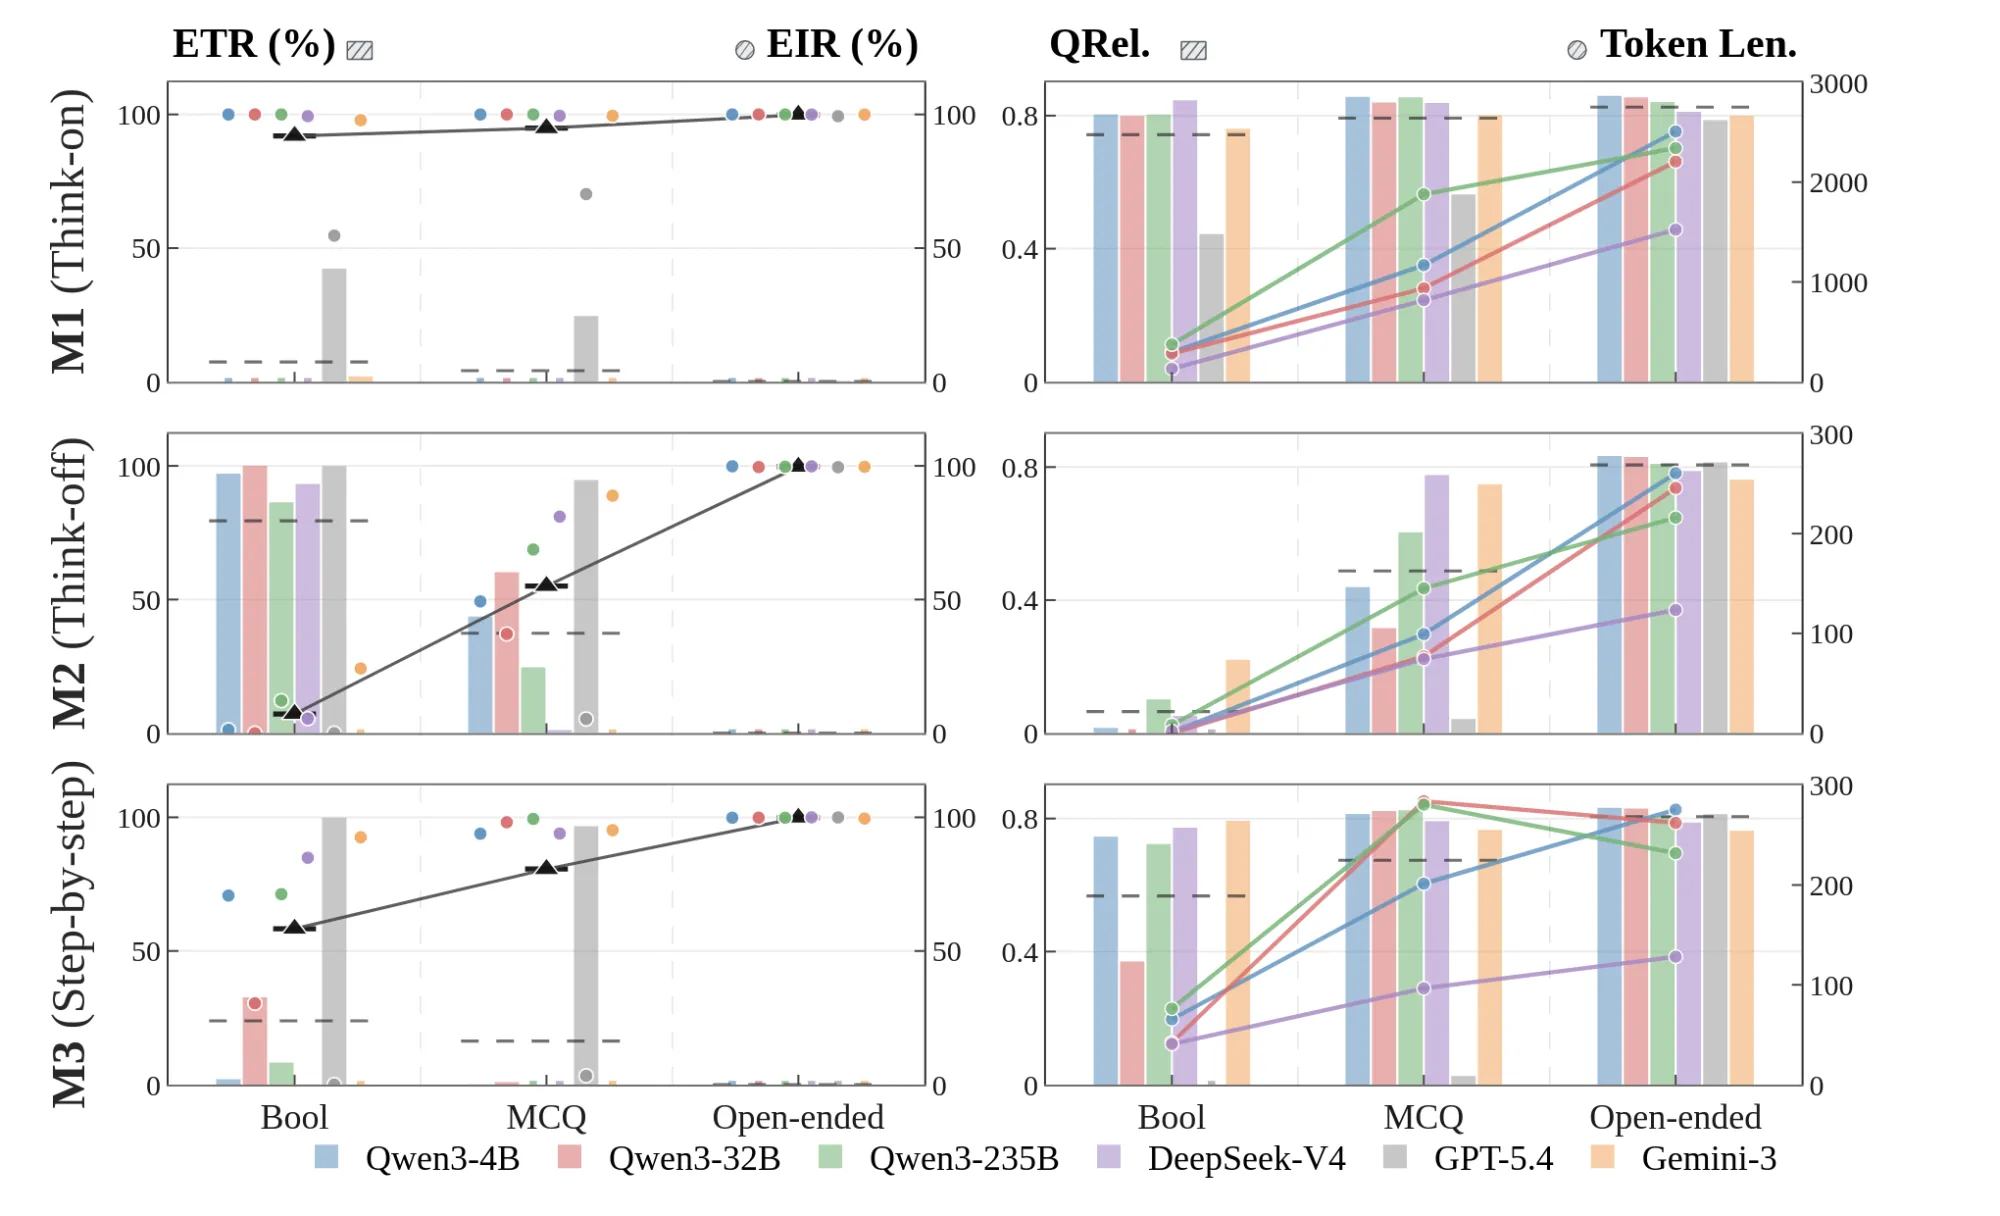
Há um preço. Nas tarefas abertas, forçar a resposta curta custa cerca de 15 pontos percentuais de acerto, segundo o paper. Nas de verdadeiro ou falso e de múltipla escolha a precisão ficou praticamente estável. Na média de cinco modelos com o raciocínio desligado, o prompt estrito sobe a taxa de pré-resposta vazia de perto de zero para cerca de 40%. Ou seja, ainda sobram seis em cada dez respostas com algum texto antes.
Escrever o começo da resposta no prompt também não resolveu. Segundo os autores, ela não produz de forma confiável respostas só com o resultado: em múltipla escolha e em perguntas abertas, a taxa de pré-resposta vazia ficou abaixo da obtida com o prompt estrito. O GPT-5.4 foi a exceção mais clara, com boa aderência e pouca inferência em verdadeiro ou falso e em múltipla escolha mesmo quando se pede passo a passo.
Reformular a pergunta funciona?
O resultado mais prático vem de outra direção: mudar o formato em vez de insistir no prompt. Para o Qwen3-32B, reescrever itens de múltipla escolha como perguntas de verdadeiro ou falso subiu a taxa de pré-resposta vazia de 10,5% para 62,5%, e a precisão foi de 77,8% para 78,9%. Fornecer candidatos de resposta, pelo que o paper relata, também facilita a resposta direta.
Na prática, se a tarefa admite uma lista fechada de opções, dar as opções ao modelo tende a reduzir o texto extra mais do que uma ordem de "não explique". Isso vale para roteamento de tickets, classificação de intenção e moderação, onde o conjunto de saídas já é conhecido.
Como testar na sua própria aplicação
O código de avaliação está no repositório de código do paper, com licença MIT. Ele pede Python 3.10 ou mais e um endpoint compatível com a API da OpenAI, que você fornece: dá para apontar para um Ollama local. Um comando baixa os conjuntos de dados públicos e outro roda a avaliação com as seis intervenções, medindo as três métricas. O repositório é novo, com 4 estrelas e 7 commits na página, então é código de pesquisa, não uma biblioteca madura.
Eu não rodei o código. Pelo README, o que ele entrega é uma bancada para medir o seu modelo contra as mesmas intervenções, e isso já tem valor: dá para saber quanto do seu "sem pensar" é pensamento mesmo.
Quais são os limites?
Os próprios autores listam os limites no paper. A análise vê só a resposta observável, não a computação interna do modelo. São seis conjuntos de dados, sem teste em outros idiomas, código, uso de ferramentas, conversas de vários turnos nem amostragem aleatória. O juiz depende de uma rubrica, e a checagem com um segundo juiz deu taxas parecidas. Endpoints proprietários também podem mudar com o tempo, e o Gemini em esforço "mínimo" não é exatamente desligado.
Minha leitura é que o paper desfaz uma suposição confortável: configurar um parâmetro não é o mesmo que medir o comportamento. Se a sua aplicação paga por token, vale medir o texto que antecede a resposta antes de apostar na instrução, e preferir tarefas com resposta de lista fechada. O que me falta ver é o mesmo teste em português e com agentes que chamam ferramentas, que é onde eu mais uso modelos e onde o custo de um parágrafo extra por chamada se acumula.
Fontes
- Thinking Inertia: LLMs Keep Thinking When Told Not To, arXiv, 8 out. 2026
- thinking-inertia/code, GitHub, out. 2026
Gostou? Receba o próximo
Um e-mail a cada post novo. Sem spam.