Muse Spark Open, da Meta, tem pesos abertos, mas pede ao menos 700 GB de memória
O Muse Spark Open é o modelo aberto mais capaz dos EUA, segundo a Meta, mas fica atrás de GLM 5.3 e Kimi K3 no índice da Artificial Analysis e pede ao menos 700 GB de memória.
A Meta publicou nesta quinta, 15 de outubro, os pesos do Muse Spark Open, um modelo de 816 bilhões de parâmetros que a empresa chama de o mais capaz entre os de pesos abertos dos Estados Unidos, segundo o TechCrunch. O arquivo passa de 1 TB, e a versão de 4 bits pede ao menos 700 GB de memória de vídeo, conforme o model card no Hugging Face. Para quem constrói com IA local, a pergunta é o que dá para fazer com um modelo desse tamanho.
O que a Meta lançou
O Muse Spark Open é a versão de pesos abertos da família Muse Spark. Ele aceita texto, imagem, vídeo e áudio na entrada, responde só com texto e tem janela de contexto de 1 milhão de tokens, conforme o model card. A Meta o descreve como feito para programação e tarefas de agentes, e o TechCrunch conta que ela o mostrou ao lado do Muse Code, seu terminal de programação com IA, corrigindo bugs de um cliente do Mastodon, segundo o TechCrunch.
O raciocínio não pode ser desligado. O post do Hugging Face explica que existem quatro níveis de esforço (baixo, médio, alto e extra alto), que o padrão é o extra alto e que não há modo sem raciocínio. Isso pesa no custo por resposta, porque o modelo sempre gasta tokens pensando. Desligar o raciocínio também não resolve em outros modelos, como mostrou o caso do Thinking Inertia.
Por que um modelo de 816 bilhões pede tanta memória
O modelo usa a arquitetura de mistura de especialistas (MoE, na sigla em inglês): em vez de ativar todos os parâmetros para cada token, ele tem 256 blocos especialistas por camada e escolhe 8 por token. Por isso são 816 bilhões de parâmetros no total, mas só cerca de 42 bilhões trabalham a cada token, conforme o post do Hugging Face.
Isso reduz a conta de processamento, mas a memória continua alta. Todos os especialistas precisam estar carregados, e eles concentram cerca de 97% dos parâmetros, segundo o mesmo post. O resultado é um arquivo de cerca de 1,5 TB em BF16 (16 bits por número) e um cache de contexto de cerca de 250 KB por token, o que dá uns 266 GB para usar o 1 milhão de tokens inteiro.
A versão NVFP4 guarda cada peso em 4 bits e roda em GPUs NVIDIA Blackwell. O model card diz que ela pede ao menos 700 GB de memória de vídeo, contra cerca de 2 TB do BF16. Na nuvem, a AWS oferece as duas versões no SageMaker JumpStart, nas instâncias ml.p5e.48xlarge (NVFP4) e ml.p6-b300.48xlarge (BF16), só nas regiões do leste dos EUA, com a implantação levando de 15 a 20 minutos.
Os números: o mais capaz dos EUA, mas não o mais capaz de todos
Os benchmarks vêm do próprio model card, ou seja, são resultados que a Meta escolheu publicar. No índice de inteligência da Artificial Analysis, que agrega vários testes numa nota só, a tabela mostra o Muse Spark Open com 39 pontos, atrás do GLM 5.3 (45), do Kimi K3 (44) e do Qwen3.8 de 2,4 trilhões de parâmetros (40), e à frente do Mistral Large 4 (38), segundo o model card.
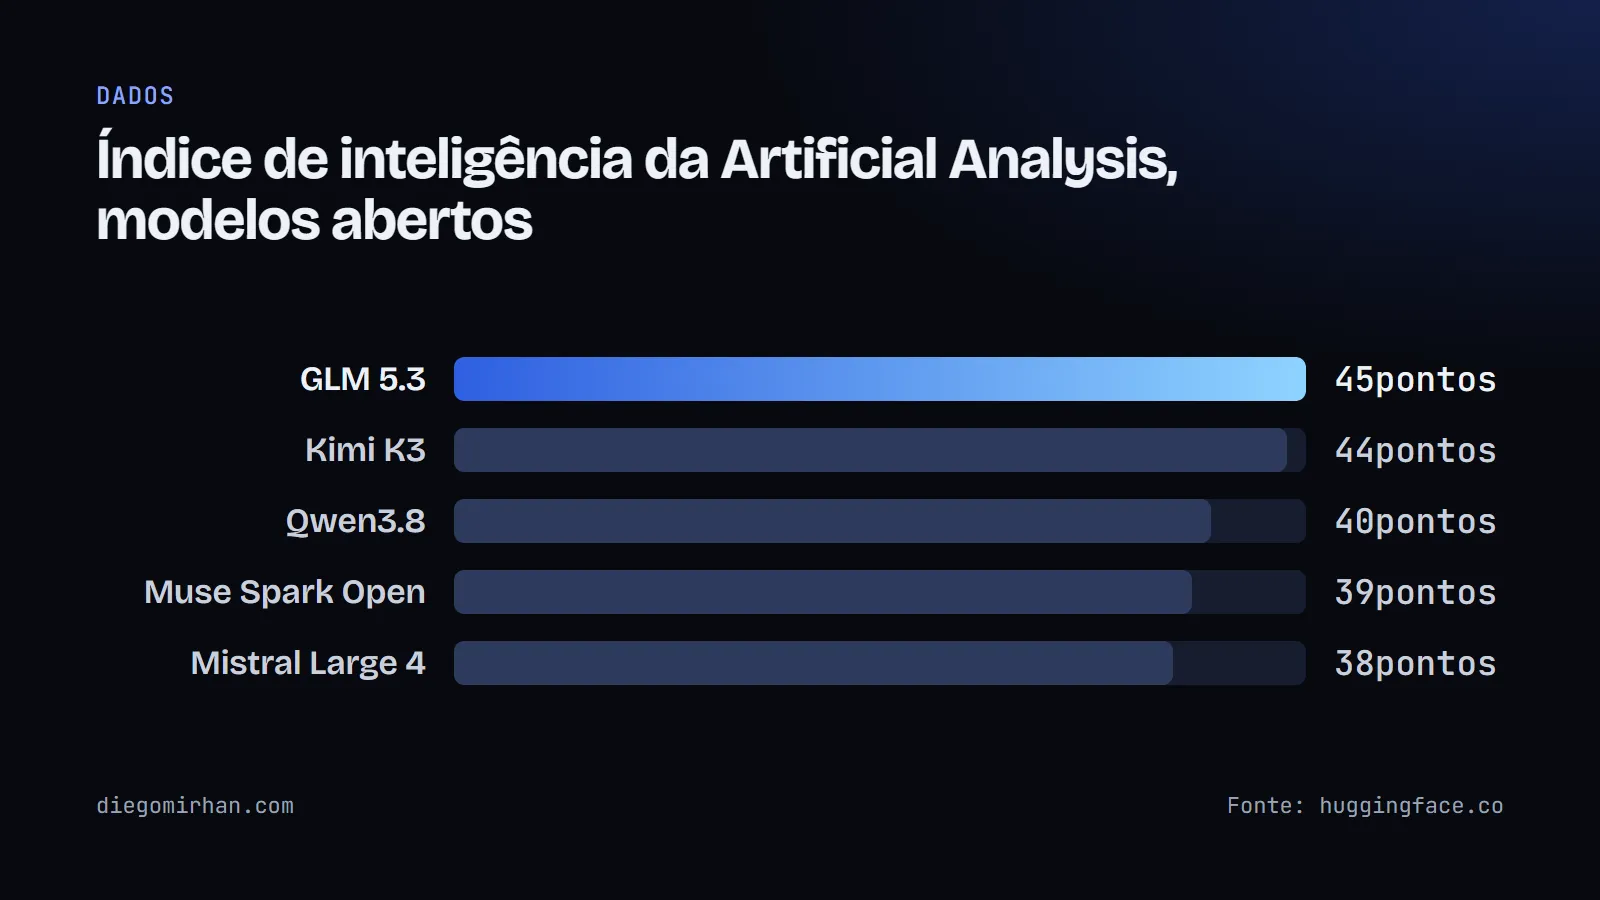
Então o "mais capaz dos EUA" vale por exclusão: a tabela não inclui outro modelo americano de pesos abertos acima dele, e os dois primeiros colocados são chineses. A pontuação do Mistral Large 4 também chama atenção porque a Mistral ainda não liberou os pesos do Large 4, previstos para o fim de outubro.
O modelo lidera em alguns testes. No MCP-Atlas, de uso de ferramentas, faz 89,2, contra 84,5 do Qwen3.8 e 84,2 do GLM 5.3, e no HLE-Diamond, de questões difíceis sem ferramentas, faz 26,1, contra 22,2 do Kimi K3, conforme o model card. Fica atrás nos de programação: 60 no DeepSWE 1.1, contra 67 do GLM 5.3 e 68 do Kimi K3, e 76,4 no Terminal-Bench 2.1, contra 83,9 e 85,0. Para um modelo vendido como feito para código, é o dado que mais merece teste próprio.
Dá para rodar em casa?
Depende do que se chama de casa. O post do Hugging Face mostra o caminho: no llama.cpp, uma quantização de 2 bits ocupou 304 GB e gerou cerca de 18 tokens por segundo num Mac M3 Ultra de 512 GB, e no MLX, a quantização oQ3e (cerca de 344 GB) gerou cerca de 21 tokens por segundo na mesma máquina. Quantizar é guardar cada peso com menos bits, o que encolhe o arquivo e tira um pouco de precisão. O post não mede a perda de qualidade das versões de 2 e 3 bits.
A Meta destaca a execução em Macs: o model card cita dois Mac Studio com chip M5 Ultra usando MLX, e o TechCrunch diz que o modelo roda melhor num Mac Studio com M5 Ultra, segundo o TechCrunch. Numa placa AMD de uso doméstico, como a que eu uso, nada disso cabe. O modelo está fora do alcance de um PC comum.
Resta a nuvem. O TechCrunch confirma que o modelo já está disponível em plataformas de API, mas não nomeia as plataformas nem traz preços, segundo o TechCrunch.
A licença e o que muda para quem constrói
Pesos abertos, aqui, não significa licença livre. O model card diz que a Muse Model License permite usar, modificar, destilar e vender, mas exige exibir "Built with Muse Spark Open" nos produtos que o usam. Quem oferece o modelo a terceiros por API e passa de US$ 20 milhões de receita bruta em 12 meses precisa avisar a Meta e assinar um acordo à parte, segundo o model card. Uso interno, pesquisa e produtos que usam o modelo como componente ficam fora dessa regra.
Minha leitura é que o Muse Spark Open é um modelo para quem tem cluster, e não para quem roda IA local de verdade. Para uma empresa que precisa manter dados dentro de casa e já tem GPUs Blackwell, ele vira uma opção séria, com contexto longo e entrada de áudio e vídeo. Para estudante e desenvolvedor solo, o ganho está em ver o que os provedores de API fazem com ele, porque o preço por token vai dizer mais que o título de "mais capaz dos EUA". O que me faria mudar de ideia é uma quantização de 4 bits que caiba numa máquina de 256 GB sem perder a nota em programação.
Fontes
- Meta launches an open-weight AI model that runs on Macs, TechCrunch, 15/10/2026
- Muse-Spark-Open-816B-A42B (model card), Hugging Face / Meta, 15/10/2026
- Welcome Muse Spark Open: open-weight frontier multimodal mixture-of-experts model from Meta, Hugging Face, 15/10/2026
- Meta's Muse Spark Open now available in Amazon SageMaker JumpStart, AWS, 15/10/2026
Gostou? Receba o próximo
Um e-mail a cada post novo. Sem spam.