Mais da metade dos preprints de matemática vai citar IA até o fim de 2027
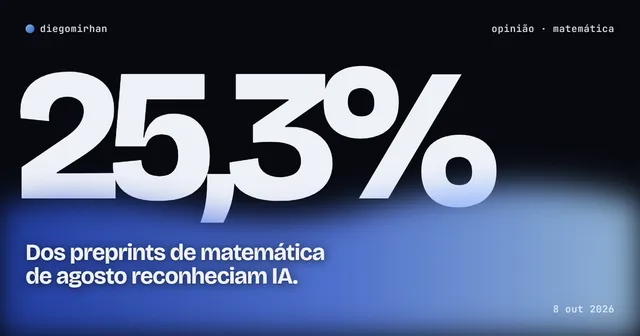
Em agosto, 25,3% dos preprints de matemática no arXiv reconheciam o uso de IA, contra 3,9% em abril. Minha previsão para 2027 e o que me faria errar.
Em agosto, 25,3% dos preprints de matemática no arXiv reconheciam o uso de IA, contra 3,9% em abril. Minha previsão para 2027 e o que me faria errar.
Um paper de 23 de outubro testa quatro harnesses e nove modelos em 95 tarefas. A nota de harness vai de 59,8% a 72,0%, e a tarefa passa mesmo com falha.
Um paper de 22 de outubro compara o Raw-RAG, uma busca simples sobre o histórico bruto, com 12 sistemas de memória de agentes. Ele ganha em 6 de 7 testes.
Agent Skills, Open Responses, OpenEnv e OpenSandbox passam a ser mantidos pela Agentic AI Foundation. O que cada um faz e o que ainda falta saber.
Em quatro meses a Nvidia lançou o Nemotron 3 Ultra e os modelos 3.5, com pesos e receitas abertos. Minha aposta para os próximos 12 meses e o que me faria errar.
O gasto de pesquisadores da OpenAI com agentes de código dobra a cada mês. Uber e Red Hat já põem limite por pessoa. Minha aposta para 2027 e o que me faria errar.
O OpenGCUA deixa o modelo escrever um programa por passo em vez de clicar. Em oito modelos, a nota sobe 19,6 pontos e os passos caem 53%. O código é Apache-2.0.
O Muse Spark Open é o modelo aberto mais capaz dos EUA, segundo a Meta, mas fica atrás de GLM 5.3 e Kimi K3 no índice da Artificial Analysis e pede ao menos 700 GB de memória.
Os maiores data centers de IA planejam passar de 1,5 GW até 2028. Minha aposta é que a rede pública não acompanha e que a energia vira parte do preço do token.
O paper Thinking Inertia mostra que desligar o raciocínio ou pedir só a resposta não zera o texto extra. Em perguntas abertas, o acerto cai cerca de 15 pontos.
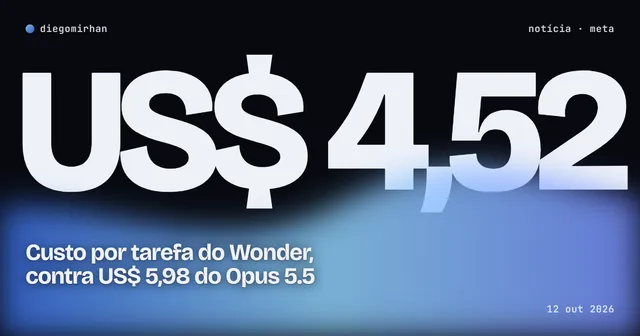
O Muse Wonder custa o mesmo que o Opus 5.5 por token, mas gasta mais tokens por tarefa. O Full, mais forte, só existe em assinatura do Muse Code.
O TokenRouter, aceito no NeurIPS 2026, deixa um LLM pequeno e um grande dividirem a resposta token a token, com de 2 a 64 vezes mais vazão que o estado atual.